Jev Ultrafast : un Google Flights en 7 secondes, sans une seule capture d’écran
TL;DR. Le 16 septembre 2026, Browser Use a publié Jev Ultrafast, un agent navigateur open source (licence MIT, 1 contributeur principal) qui pilote Chrome sans jamais prendre de capture d’écran. La démo fait un Zurich-Londres sur Google Flights en 7,073 secondes, texte généré et attentes de chargement inclus. Sur six exécutions alternées, le temps médian passe de 9,450 s à 7,092 s et les appels au protocole navigateur de 1 092 à 101. Le dépôt est passé de 0 à 10 031 étoiles GitHub en quatre jours. Ce n’est pas un produit fini : c’est une preuve de méthode qui rend crédible une catégorie d’automatisation qu’on avait enterrée un peu vite, le RPA moderne. Six limites documentées par les auteurs eux-mêmes interdisent quand même de la mettre en production demain matin.
Un agent qui navigue sur le web, ça n’a rien de nouveau. Ce qui est nouveau, c’est un agent qui navigue sans regarder l’écran.
Le 15 septembre 2026, TypeSafe AI annonçait Jev, un modèle qui ne produit pas du texte mais des décisions typées avec confiance calibrée. Le lendemain soir, à 21h30 UTC, le dépôt browser-use/jev-ultrafast apparaissait sur GitHub. Quatre jours plus tard il dépassait les 10 000 étoiles, avec 612 forks et 62 issues ouvertes.
Entre les deux, il n’y a pas un nouveau modèle de frontière. Il y a une idée d’architecture, appliquée à un des problèmes les plus coûteux de l’automatisation en entreprise : faire cliquer un logiciel à notre place dans un navigateur.
Ce que Browser Use a publié exactement
Le dépôt a une description de quatre mots : « i. am. speed. ». Le README, lui, tient en une phrase de méthode : donner un objectif en langage naturel, et laisser Jev choisir une opération et un élément. Un petit LLM écrit du texte uniquement quand l’opération est TYPE_TEXT.
| Élément |
Valeur constatée au 20 septembre 2026 |
| Dépôt |
browser-use/jev-ultrafast |
| Première publication |
16 septembre 2026, 21h30 UTC |
| Licence |
MIT |
| Langage |
Python (plus un fichier snapshot.js) |
| Étoiles |
10 031 |
| Forks |
612 |
| Issues ouvertes |
62 |
| Dernier commit |
18 septembre 2026, 16h28 UTC |
| Accès cloud |
Liste d’attente ouverte le 18 septembre |
Ce n’est pas un projet de recherche isolé. C’est la rencontre de deux équipes : Browser Use, qui a construit la bibliothèque d’agents navigateur la plus utilisée de l’écosystème open source, et TypeSafe AI, qui vend un modèle de décision à 114 millisecondes.
Un dépôt volontairement minuscule
Six fichiers portent tout le comportement de l’agent. C’est un choix éditorial autant qu’un choix technique : les auteurs veulent qu’un ingénieur puisse relire la boucle complète en une heure.
| Fichier |
Rôle |
agent.py |
La boucle complète et le passage de relais au générateur de texte |
snapshot.js |
Photographie DOM atomique, contrôles indexés, garde-fous de fraîcheur |
browser.py |
Connexion au navigateur, géométrie courante, exécution |
model.py |
Têtes d’opération et de cible dynamiques, génération de texte |
questions.py |
Instructions envoyées au modèle |
demo.py |
Inspecteur local, qui affiche les probabilités d’opération et de cible |
Le reste du dépôt, ce sont des tests hors ligne, des scripts de mesure et la mécanique de la démonstration. Aucun script d’action spécifique à un site, aucune chaîne de caractères préremplie dans la politique du modèle.
La démo qui sert de preuve
La vidéo publiée joue à vitesse 1x. On y voit un objectif en langage naturel, des noms de villes réellement générés, et des décisions opération/cible prises en direct. La mesure retenue est de 7,073 secondes pour un vol aller simple Zurich vers Londres le 20 septembre 2026, un adulte, classe économique.
La démonstration officielle, jouée à vitesse réelle, sans coupe. Le bandeau de droite affiche la chronologie des décisions, la latence médiane de décision et la vérification finale de la route et de la date. Source : dépôt browser-use/jev-ultrafast, fichier docs/demo.mp4.
Le point intéressant n’est pas le chiffre. C’est que la vérification du résultat est indépendante : un contrôle séparé confirme le réglage aller simple, Zurich, Londres, la date et l’affichage d’options de vol correspondantes. Un agent qui déclare avoir fini n’est pas un agent qui a fini, et les auteurs l’ont intégré dès le premier jour.
Pourquoi les agents navigateur ramaient
Pour comprendre l’apport, il faut se souvenir du problème que tout le monde avait accepté comme une fatalité.
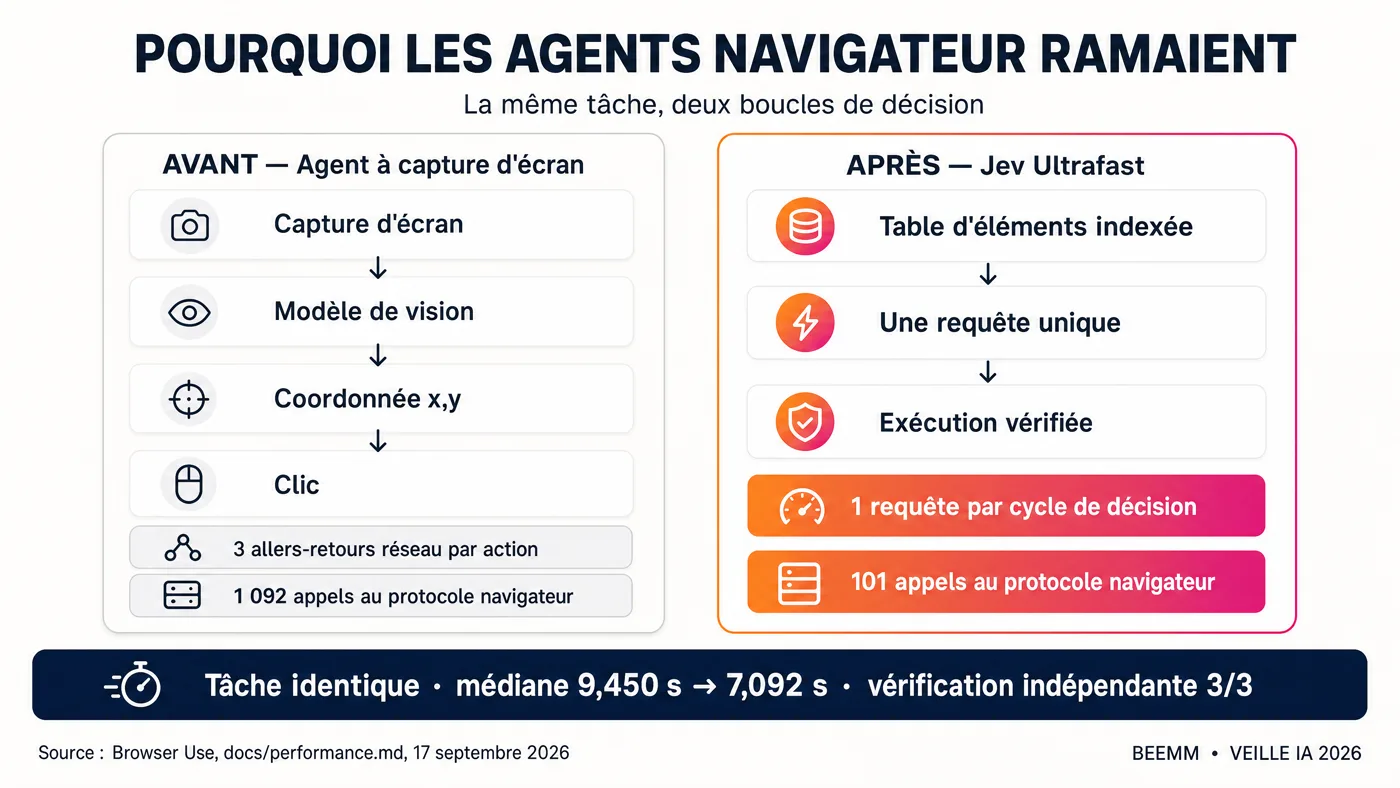
L’approche dominante depuis 2024 ressemble à ça : on prend une capture d’écran de la page, on l’envoie à un modèle multimodal, on lui demande où cliquer, il répond une coordonnée, on clique, on recommence. Trois allers-retours réseau par action, et surtout une quantité énorme d’information déjà connue du navigateur qui repasse par des pixels.
Le coût caché de la capture d’écran
Une page web, pour la machine qui l’affiche, n’est pas une image. C’est un arbre d’objets avec des rôles, des noms accessibles, des valeurs, des états activé ou désactivé. Tout ce qu’un modèle de vision doit deviner en examinant une image compressée, le navigateur le sait déjà avec certitude.
Envoyer une capture d’écran pour redécouvrir cette information a trois conséquences directes :
- Le temps. L’encodage et le transfert d’une image coûtent plus cher que l’envoi d’un tableau de texte structuré.
- La précision. Un modèle qui lit des pixels se trompe sur les cas limites : deux boutons qui se ressemblent, un libellé tronqué, un contrôle grisé.
- L’auditabilité. Un clic sur des coordonnées est difficile à expliquer après coup. Un clic sur « l’élément numéro 7 de type button » est reconstituable.
Trois allers-retours pour un seul clic
Dans le schéma classique, une action simple demande de décrire l’écran, de choisir une action, puis de choisir une cible : le plus souvent deux ou trois appels au modèle, sans parler des appels au navigateur pour observer la page. C’est ce que Jev Ultrafast attaque frontalement.
L’action space dynamique : la vraie idée
Le terme technique du dépôt est « dynamic, indexed action space ». En clair : à chaque observation, l’agent fabrique une nouvelle table d’éléments numérotés, et il n’a le droit de choisir qu’à l’intérieur de cette table.
La table d’éléments indexée
Concrètement, une page de recherche de vols produit quelque chose comme :
| Index |
Rôle |
Nom accessible |
Valeur |
| 1 |
button |
Change ticket type - Round trip |
vide |
| 2 |
combobox |
Where from? |
San Francisco |
| 3 |
combobox |
Where to? |
vide |
| 4 |
textbox |
Departure |
vide |
C’est tout. Le modèle reçoit cette table, pas des pixels. Les éléments hors écran ou masqués n’y figurent pas. Seuls les contrôles visibles, avec leur nom et leur valeur, entrent dans le contexte.
Une seule requête par cycle de décision
Le point clé est là : la question « quelle opération ? » et la question « quelle cible ? » sont évaluées contre le même état observé, dans une seule requête. Les têtes de cible sont spéculatives : l’agent demande en une fois la cible la plus probable pour un clic, la cible la plus probable pour une saisie de texte, et la cible la plus probable pour une sélection, sachant qu’une seule d’entre elles sera exécutée, celle qui correspond à l’opération gagnante.
Chaque tête ne contient que les éléments compatibles. Une cible de saisie de texte ne propose pas de bouton. C’est un détail qui explique une bonne partie des 101 appels au protocole navigateur de la version optimisée, contre 1 092 dans la version d’origine.
Il faut mesurer ce que 1 092 veut dire. Ce n’était pas 1 092 décisions du modèle, c’était 1 092 micro-lectures de la page : on relisait l’arbre d’accessibilité en boucle, on résolvait des centaines de nœuds DOM, et chaque mutation du DOM, y compris une animation, invalidait la décision en cours. La version corrigée fait une lecture atomique des contrôles HTML et ARIA visibles, conserve des références vers les vrais nœuds DOM, et ne force plus de nouvelle prédiction pour une simple animation.
Ce que le modèle n’a plus le droit de faire
Un point mérite d’être souligné pour toute personne qui doit faire valider ce genre d’outil par une équipe sécurité. La sortie du modèle ne devient jamais un sélecteur CSS, une coordonnée, une commande shell ou du JavaScript exécutable. Le modèle choisit un index dans une liste observée. L’exécuteur revérifie ensuite que la page n’a pas changé, que la cible existe toujours, qu’elle n’est pas recouverte par une surcouche, et recalcule sa géométrie avant d’envoyer l’entrée.
Et la sortie du générateur de texte doit être un petit objet JSON valide avant d’être tapée dans un champ. Si le modèle de texte part en commentaire, rien n’est saisi.
Le seul endroit où un LLM écrit encore du texte
L’architecture n’élimine pas les modèles de langage. Elle les cantonne. Dans cette boucle, un LLM classique intervient pour une seule chose : produire la valeur d’un champ quand l’opération est une saisie, par exemple « Zurich » dans un champ ville de départ.
C’est le point de fragilité assumé. Sur l’enregistrement publié, la génération a pris 581 millisecondes pour Zurich et 346 millisecondes pour Londres, via inception/mercury-2.5 sur OpenRouter, avec le raisonnement désactivé. En tout, l’enregistrement compte 17 requêtes Jev, 10 interactions, une attente explicite, et deux appels au générateur de texte. La latence médiane de Jev y est de 178 millisecondes.
Les auteurs documentent aussi les modèles qu’ils ont écartés : un modèle qui inversait ville de départ et ville d’arrivée, un autre qui produisait du commentaire au lieu d’un JSON valide. C’est le passage le plus honnête du dépôt. La qualité du texte généré reste le maillon faible de la chaîne, et elle ne se règle pas avec un meilleur prompt, elle se règle avec un modèle qui sait sortir un JSON court.
Les chiffres publiés, et ce qu’ils ne prouvent pas
Les auteurs ont publié leurs mesures brutes, y compris la façon dont ils comptent. C’est assez rare pour être noté.
| Mesure |
Version d’origine |
Version optimisée |
| Temps médian sur la tâche |
9,450 s |
7,092 s |
| Requêtes TypeSafe (médiane) |
22 |
17 |
| Appels au protocole navigateur (médiane) |
1 092 |
101 |
| Vérification indépendante |
3/3 |
3/3 |
Trois paires d’exécutions alternées, une seule tâche, un seul profil Chrome, vérification indépendante dans les deux bras. Deux autres vérifications ponctuelles existent : l’ouverture de l’article de Wikipédia sur les théorèmes d’incomplétude de Gödel en 2,798 secondes, et une recherche hôtelière sur une page locale avec trois filtres appliqués en 1,896 secondes.
Les quatre limites de la mesure, écrites noir sur blanc
Ce que les auteurs disent eux-mêmes, et qu’il faut répéter avant de citer les 7 secondes en réunion :
- Le chronomètre démarre après l’observation initiale de la page. La navigation vers Google Flights et la toute première lecture ne sont pas dans le temps annoncé.
- Trois paires, c’est trop peu. Le test du signe donne p = 0,25. Les auteurs écrivent noir sur blanc qu’un intervalle de 25 % sur trois répétitions d’une tâche n’est pas une preuve statistique.
- Le réseau et Google restent vivants. Réponses réseau, routage, caches navigateur : rien n’est figé, donc rien n’est reproduit en laboratoire.
- Le coût total n’est pas publié. On connaît la facture des deux appels de génération de texte sur OpenRouter : 0,00006272 dollar, soit six millièmes de centime. Ce n’est pas le coût de la tâche. Les réponses de TypeSafe donnent des compteurs de jetons, 90 558 en entrée et 6 325 en sortie, sans montant facturé, et les coûts navigateur sont exclus.
Sur ce dernier point, la communauté n’a pas attendu longtemps pour réagir. Un commentateur a résumé la critique la plus citée : le chronomètre démarre après l’observation initiale de la page, qui est justement la partie lente. C’est un argument recevable sur la forme de la mesure. Il ne détruit pas l’apport de fond, parce que les deux bras comparés excluent la même étape, mais il interdit de présenter les 7 secondes comme un temps de tâche complet.
Ce que le dépôt corrige quand même
L’intérêt de la comparaison n’est pas le 25 %. C’est la ligne des 1 092 contre 101. Un agent qui déclenche un millier d’appels de protocole pour faire une recherche de vol ne passera jamais à l’échelle sur des processus réels, quelle que soit la puissance du modèle derrière. Un agent qui en déclenche cent et qui tient la même réussite, oui. C’est exactement le type de gain qui ne vient pas d’un modèle plus gros mais d’un meilleur découpage du travail.
Ce que 48 heures de Hacker News ont révélé
Le fil Hacker News ouvert le 17 septembre a réuni 89 points et 14 commentaires. Il est plus instructif que la vidéo, parce qu’il contient les objections que votre direction posera.
L’objection de sécurité, la plus sérieuse
Un commentateur raconte avoir inspecté les entrailles de Browser Use pour faire tourner ses propres tests avec un navigateur local et le fournisseur de modèle de son choix. Sa conclusion : la télémétrie activée par défaut et envoyée à PostHog est massive, et le composant de connexion au navigateur peut laisser fuir des identifiants.
Je n’ai pas reproduit cette analyse, donc je la rapporte comme un témoignage et non comme un fait établi. Mais elle définit la question à poser avant toute expérimentation : quel composant parle à quel serveur, par défaut, et comment on le désactive. C’est la même question qui bloque les déploiements d’agents dans à peu près tous les grands groupes, et elle ne se règle pas avec un argument de vitesse.
« Ça ne marche pas »
Plusieurs commentaires rapportent une erreur au moment de lancer la démo, un autre se contente d’un « Doesn’t work ». Un utilisateur a trouvé la manipulation : après avoir cliqué sur « Start Demo », il faut glisser l’onglet nouvellement créé dans sa propre fenêtre pour voir ce qui se passe, puis lancer l’exécution automatique. C’est un problème d’expérience développeur, pas d’architecture, mais il explique une partie de la mauvaise presse : un dépôt qui promet la vitesse et qui échoue à l’installation perd son audience en dix minutes.
« C’est un switch intelligent »
Le commentaire le plus intéressant du fil tient en une phrase : on dirait presque un switch bien écrit. C’est une critique et un compliment à la fois. Une partie des commentateurs y voit une régression, une façon de transformer un raisonnement en table de correspondance. Une autre répond que le sujet n’est pas là : ce modèle fait de la classification, du branchement programmatique et de la décision en temps réel, une décision de grandeur plus vite et moins cher, y compris pour la robotique.
Les deux lectures sont vraies. Un agent navigateur n’a pas besoin de philosophie pour choisir entre cliquer et saisir du texte. Il a besoin d’avoir raison vite et de pouvoir expliquer pourquoi. C’est le coeur du basculement System One déjà décrit pour le modèle Jev lui-même : TypeSafe AI et Jev, le premier vrai modèle d’IA post-LLM.
Le clonage a commencé
Dès le lendemain, un dépôt tiers, jevlike, apparaissait, et un commentateur demandait une version locale du modèle, capable de tourner sur du matériel grand public pour ne pas « payer une taxe IA à chaque usage ». Le mouvement est engagé, et il est bien plus rapide sur la couche agent que sur les modèles eux-mêmes. C’est une bonne nouvelle pour les équipes qui veulent tester sans convaincre un acheteur.
Les six limites documentées, et pourquoi elles comptent
Le README a une section « Evidence and limits ». Elle est aussi importante que la vidéo, parce qu’elle dessine le périmètre réel de l’outil.
1. Les composants modernes échappent au lecteur DOM
Le lecteur prend en charge les contrôles HTML et ARIA courants. Il n’implémente pas la spécification complète du nom accessible, et il ne traverse ni les racines fantômes (shadow roots) ni les cadres intégrés (iframes). Restent hors périmètre : les canevas (canvas), les téléversements de fichiers, les onglets surgissants, le défilement imbriqué et les widgets à clavier arbitraires.
Traduction pour une direction des systèmes d’information : le portail maison en React avec une grille de données virtualisée n’est pas couvert. L’extranet en iframe non plus. L’outil marche là où le HTML est classique, ce qui reste la majorité des back-offices métier, mais il faut le vérifier site par site avant de promettre quoi que ce soit.
2. DONE n’est pas une preuve
L’agent peut choisir de terminer. Ce choix n’est jamais une preuve de réussite. C’est écrit dans le README, et l’outil de vérification existe justement parce que le modèle peut se tromper sur une opération pourtant valide. Toute automatisation en production doit donc embarquer son propre contrôle de résultat, en base ou dans le système cible. C’est exactement le même constat que dans notre article sur les sept bascules de 2026, où les agents qui atteignent vraiment la production sont ceux qui sont évalués plutôt que crus sur parole.
3. Le profil Chrome est partagé
Les onglets pilotés utilisent le profil Chrome existant. Pour une démonstration personnelle, c’est confortable : les sessions sont déjà ouvertes. Pour un usage en entreprise, c’est un problème de gouvernance immédiat : quelles sessions l’agent peut-il utiliser, comment on limite son périmètre, comment on prouve après coup qu’il n’a pas touché à autre chose.
4. Le coût réel par tâche reste à établir
Comme vu plus haut, seuls les deux appels de génération de texte sont chiffrés à 0,00006272 dollar. Toute décision budgétaire exige un compteur de coût par processus, pas une extrapolation depuis une démonstration.
5. Ce n’est pas un produit, c’est un MVP
Un seul contributeur principal, 62 issues ouvertes, aucune version publiée au 20 septembre. Le dépôt est un socle lisible, pas un logiciel supporté. La liste d’attente ouverte le 18 septembre pour le cloud montre bien où les auteurs veulent aller : vers une offre hébergée, pas vers un fichier de configuration à installer.
6. Aucune donnée française
La démonstration se fait sur Google Flights, Wikipédia et une page hôtelière locale. Aucun test sur un ERP français, un outil de gestion de paie, un back-office bancaire. C’est le travail à faire, et il prend du temps.
Ce que ça change pour un grand groupe français
Trois conséquences concrètes, dans l’ordre où elles se posent dans un comité de direction.
Le RPA redevient crédible
Le RPA des débuts avait un défaut connu : il cassait dès que l’interface changeait, et il fallait un développeur pour réparer un sélecteur. Les agents fondés sur la vision ont promis de régler ça, mais au prix d’une lenteur et d’un coût qui les cantonnaient aux démonstrations. Un agent qui lit une table d’éléments indexée est un entre-deux : il s’adapte comme un agent, et il reste assez rapide pour tenir une cadence métier.
Un agent qui ne regarde pas des pixels est un agent auditable
Point sous-estimé : quand un agent choisit entre des éléments numérotés, chaque décision s’écrit dans un journal lisible par un humain. « Cinq secondes plus tôt, il a choisi l’élément 3, combobox Where to?, parce que l’opération TYPE_TEXT avait la probabilité la plus élevée. » Ce type de trace se discute avec un auditeur. Une coordonnée de clic à 743 pixels du bord ne se discute pas.
Où ça se branche en premier
Chez Beemm, on n’a pas encore de recul client à publier sur Jev Ultrafast lui-même : le dépôt a quatre jours et l’API TypeSafe est en accès restreint. Ce qu’on observe en revanche dans les projets d’automatisation qu’on accompagne, c’est un déplacement de la question. Il y a un an, la demande portait sur « quel modèle choisir ». Aujourd’hui elle porte sur « quelle boucle de décision on contrôle », et les équipes qui progressent sont celles qui écrivent la boucle avant de choisir le modèle.
Trois familles de processus reviennent systématiquement dans les ateliers de cadrage que mène Guic avec les directions métier :
- La saisie de pièces dans un outil maison. Factures fournisseurs, formulaires de sinistres, dossiers d’adhésion. Volumétrie élevée, interface stable, aucune API. C’est le cas d’usage le plus rentable, parce que le temps humain par dossier est connu et la vérification est facile à instrumenter.
- La reprise de données entre deux applications. Un extranet fournisseur, un portail de commande, un outil métier sans connecteur. Le gain n’est pas la vitesse, c’est la suppression de la double saisie.
- La surveillance de portails. Vérifier l’état d’un dossier ou d’une commande sur un site tiers, et déclencher une alerte ou une action en aval. Là, la vitesse n’a aucune importance, la fiabilité et la traçabilité en ont beaucoup.
Dans les trois cas, la question n’est pas de savoir si le 7 secondes est vrai. La question est : quand ça échoue, est-ce que quelqu’un est prévenu, et est-ce que le journal permet de comprendre pourquoi.
Ce qu’il faut faire lundi matin
- Tester le dépôt sur un seul processus, avec un profil Chrome jetable. Pas le portail du siège, pas votre session de production. Choisissez un processus où l’échec coûte presque rien et où vous saurez mesurer le temps humain actuel.
- Écrire le contrôle de résultat avant l’automatisation. Si vous ne savez pas comment vérifier automatiquement que la tâche est réussie, vous ne pouvez pas la confier à un agent, quelle que soit sa vitesse.
- Faire l’inventaire des composants. Avant de promettre un périmètre, vérifiez si les écrans cibles utilisent des iframes, des canevas ou des grilles virtualisées. C’est ce qui décide du succès, pas la qualité du modèle.
- Poser la question de la télémétrie par écrit. Quel composant émet, vers quel domaine, avec quelles données, et comment on le coupe. Faites répondre l’éditeur, gardez la réponse.
- Ne pas budgéter sur une démo. Exigez un compteur de coût par tâche sur votre propre processus avant de dimensionner quoi que ce soit.
Ce qu’il faut retenir
Jev Ultrafast n’est pas un produit. C’est une démonstration de méthode, publiée en quatre jours par une équipe qui connaît l’open source, avec ses mesures, ses échecs et ses limites.
La partie qui va rester n’est pas le chiffre de 7 secondes, discutable sur le périmètre du chronomètre. C’est la ligne 1 092 contre 101. Elle dit quelque chose de général : la performance des agents ne viendra pas seulement de modèles plus puissants, elle viendra de boucles mieux découpées, qui posent moins de questions au modèle et lui donnent un espace d’action contraint.
Pour une direction française, la conclusion est pragmatique. La catégorie des agents navigateur redevient crédible pour le back-office, et les annonces vont se multiplier d’ici la fin de l’année. La bonne posture n’est pas d’attendre la version stable, ni de déployer la démonstration. C’est de choisir un processus, d’en mesurer la valeur, et d’exiger de la traçabilité avant la vitesse. Comme le résume Samy quand on cadre ce genre de projet avec un comité de direction : l’agent le plus rapide du monde ne sert à rien si personne ne peut expliquer ce qu’il a fait à 14h32.
Les outils Beemm pour passer à l’action
Au-delà de cet article, Beemm a développé deux produits phares qui matérialisent ce qu’on décrit ici :
- beemmvision.com - plateforme créative multi-modèles, utile pour tester et comparer des boucles d’IA sur vos propres cas d’usage
- photobeemm.com - production visuelle IA, avec suivi des coûts par projet
Et si vous voulez former vos équipes sur ces sujets, notre formation dédiée aux agents et à l’automatisation est finançable OPCO (Qualiopi). 500+ personnes formées, 300+ projets livrés.
👉 Réserver un appel découverte - réponse sous 24h.
Pour aller plus loin
Articles qui complètent celui-ci :
TypeSafe AI et Jev : pourquoi c’est le premier vrai modèle d’IA post-LLM - le modèle qui rend Jev Ultrafast possible, expliqué sans jargon : décisions typées, confiance calibrée, fin du tout-chatbot.
IA 2026 : les sept bascules réelles de l’année - pourquoi les agents qui tiennent en production sont ceux qui sont évalués plutôt que crus sur parole.
Maîtriser Claude Code en 2026 : Plan Mode, CLAUDE.md, Skills, Hooks et MCP - la même logique appliquée ailleurs : contraindre l’espace d’action d’un agent plutôt que lui faire confiance.
Sources
Sept sources, toutes primaires. Les mesures sont celles publiées par les auteurs, avec leurs propres limites de protocole rappelées dans le corps du texte.
- Browser Use, jev-ultrafast (dépôt GitHub, licence MIT), première publication le 16 septembre 2026 - https://github.com/browser-use/jev-ultrafast
- Browser Use, Faster on the real web (docs/performance.md, dépôt jev-ultrafast), 17 septembre 2026 - https://github.com/browser-use/jev-ultrafast/blob/main/docs/performance.md
- Browser Use, flights-measurement.json et full-speed-measurement.json (mesures brutes de l’enregistrement) - https://github.com/browser-use/jev-ultrafast/blob/main/docs/flights-measurement.json
- TypeSafe AI, Introduction (Jev et le concept de System One model) - https://docs.typesafe.ai/introduction
- TypeSafe AI, Speculative fan-out (le motif de têtes spéculatives utilisé par la boucle) - https://docs.typesafe.ai/patterns/fan-out
- Hacker News, fil Jev Ultrafast: A browser agent with a dynamic, indexed action space, 89 points et 14 commentaires, 17 au 19 septembre 2026 - https://news.ycombinator.com/item?id=49735979
- Browser Use, Superfast mode, liste d’attente cloud, ouverte le 18 septembre 2026 - https://browser-use.com/ultrafast
Article rédigé par l’équipe Beemm : Guic (Co-fondateur & AI, ex-Stellantis 23 ans), Samy (CEO & Chief Creative Technologist), Jaja (Co-fondateur & Sales/Growth), Frat (Co-fondateur & Marketing). Dernière mise à jour : 20 septembre 2026.