TypeSafe AI et Jev : pourquoi c’est le premier vrai modèle d’IA post-LLM
TL;DR - TypeSafe AI a annoncé Jev le 15 septembre 2026 : un System One Model qui ne produit pas du texte mais des décisions typées avec confiance calibrée. Le modèle est 193x plus rapide, 444x moins cher que les LLM classiques, et promet zéro hallucination. Ce n’est pas un énième modèle de plus. C’est le premier signal d’un changement de paradigme : la fin du « tout est un chatbot ».
La phrase d’accroche du site TypeSafe AI est sobre, presque provocante : « We took the opposite research direction ». Pas « nous avons fait mieux ». Pas « nous avons fait plus ». L’opposé.
Trois ans après l’explosion des LLM chat-style (ChatGPT, Claude, Gemini), une équipe installée à San Francisco prend le contre-pied : sortir du paradigme du texte, et revenir à quelque chose de plus proche de la programmation. Pas un chatbot qui répond avec des mots. Un modèle qui retourne des décisions que votre code peut consommer directement.
Voici pourquoi c’est important.
Le problème avec les LLM pour l’automatisation
Le pattern dominant depuis 2022 est limpide : on prend un LLM, on lui pose une question, il répond en langage naturel, on espère que la réponse est bonne. Pour de la génération de contenu (articles, mails, code), ça marche. Pour de la décision automatisée dans une boucle logicielle, ça plante.
Trois défauts structurels que TypeSafe met en avant :
1. Mode dropping. Le LLM entraîné par RLHF (Reinforcement Learning from Human Feedback) est optimisé pour plaire aux humains. Résultat : il privilégie les réponses consensuelles, abandonne les réponses minoritaires, et finit par converger vers un mode dominant qui rate les cas rares mais importants.
2. Overconfidence. Le LLM n’a pas de notion de confiance. Il dit « je pense que c’est probablement du spam » avec la même assurance qu’il dirait « c’est du spam ». Pour un humain, on nuance. Pour une machine qui prend une décision, c’est inutilisable.
3. Hallucinations. Le LLM peut inventer un fait, une référence, un chiffre. Pas souvent, mais assez pour qu’aucune automatisation sérieuse ne puisse se passer d’un humain qui valide en bout de chaîne.
Conséquence directe : les LLM sont des outils d’assistance, pas des outils d’automatisation. Pour sceller un workflow de production, il faut un humain dans la boucle. Ce qui veut dire : le coût marginal d’une décision automatisée ne tombe jamais à zéro.
C’est précisément ce que TypeSafe AI attaque.
System One Models : la thèse de Kahneman appliquée à l’IA
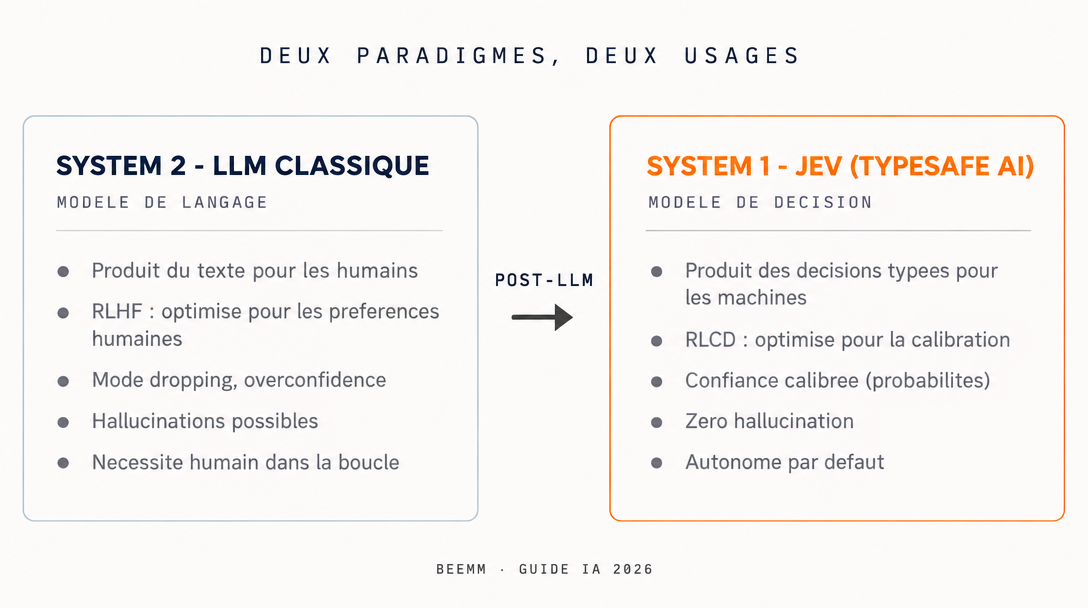
Le nom « System One » n’est pas anodin. Il vient de Daniel Kahneman (Thinking, Fast and Slow, 2011). Le psychologue distingue deux modes de pensée :
- System 1 : rapide, intuitif, automatique, pas d’effort conscient. Reconnaître un visage, freiner quand un piéton traverse, compléter la fin d’une phrase évidente.
- System 2 : lent, délibéré, logique, coûteux en énergie. Résoudre une équation, jouer aux échecs, apprendre une nouvelle langue.
Les LLM classiques sont des System 2. Ils « pensent » (CoT, chain-of-thought), délibèrent, produisent des phrases réfléchies. C’est pour ça qu’ils sont chers et lents : ils simulent la réflexion.
TypeSafe AI propose des System One : des modèles qui ne réfléchissent pas. Qui répondent vite, comme un réflexe. Qui ne sont pas entraînés pour plaire mais pour décider de manière calibrée.
La thèse : la plupart des tâches d’automatisation ne sont pas des problèmes de réflexion. Ce sont des problèmes de reconnaissance de patterns. Est-ce que ce mail est du spam ? Ce client va-t-il churner ? Cette transaction est-elle suspecte ? Cette image contient-elle le logo de notre marque ? Ce code a-t-il la vulnérabilité X ?
Toutes ces questions n’ont pas besoin d’un doctorat en sémantique. Elles ont besoin d’un classifieur rapide, type-safe, et qui sait dire « je ne sais pas ».
Jev en pratique : décisions typées et confiance calibrée
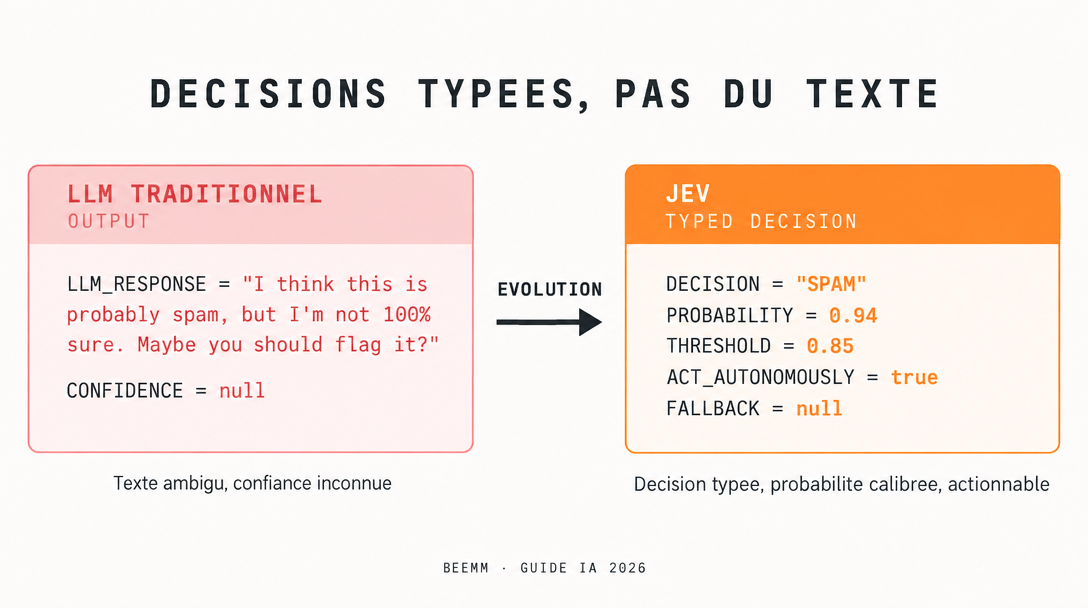
Le premier System One Model public s’appelle Jev. Voici ce qu’il retourne, sur un cas de classification de spam :
LLM classique :
{
 "response": "I think this is probably spam, but I'm not 100% sure. Maybe you should flag it?"
}
Pas de confiance. Du texte ambigu. Actionnable seulement par un humain qui relit et qui décide.
Jev (TypeSafe AI) :
{
 "decision": "SPAM",
 "probability": 0.94,
 "threshold": 0.85,
 "act_autonomously": true,
 "fallback": null
}
C’est une décision typée : un enum (SPAM ou NOT_SPAM), une probabilité calibrée (0.94), un seuil d’action (0.85), un booléen d’action autonome, un fallback optionnel. C’est du JSON strict que votre code peut parser, switcher, et exécuter. Pas d’interprétation. Pas de doute.
Trois propriétés qui changent la donne pour l’automatisation :
Confiance calibrée. La probabilité retournée reflète la vraie fréquence du résultat. Si Jev dit 0.94 sur 100 cas similaires, 94 sont effectivement des spams. Pas de calibration à re-fitter. Pas de score à reconvertir. C’est prêt pour la production.
Type-safe. Le retour a un schéma strict. Si le modèle invente un champ qu’il ne devrait pas, c’est invalidé en aval. Si le modèle veut dire MAYBE_BUT_PROBABLY_NOT, il ne peut pas : c’est SPAM ou NOT_SPAM, point.
Zéro hallucination. Une décision typée qui tombe hors du schéma est rejetée. Le modèle peut être incertain, mais il ne peut pas inventer une troisième catégorie qui n’existe pas.
Les chiffres qui font mal
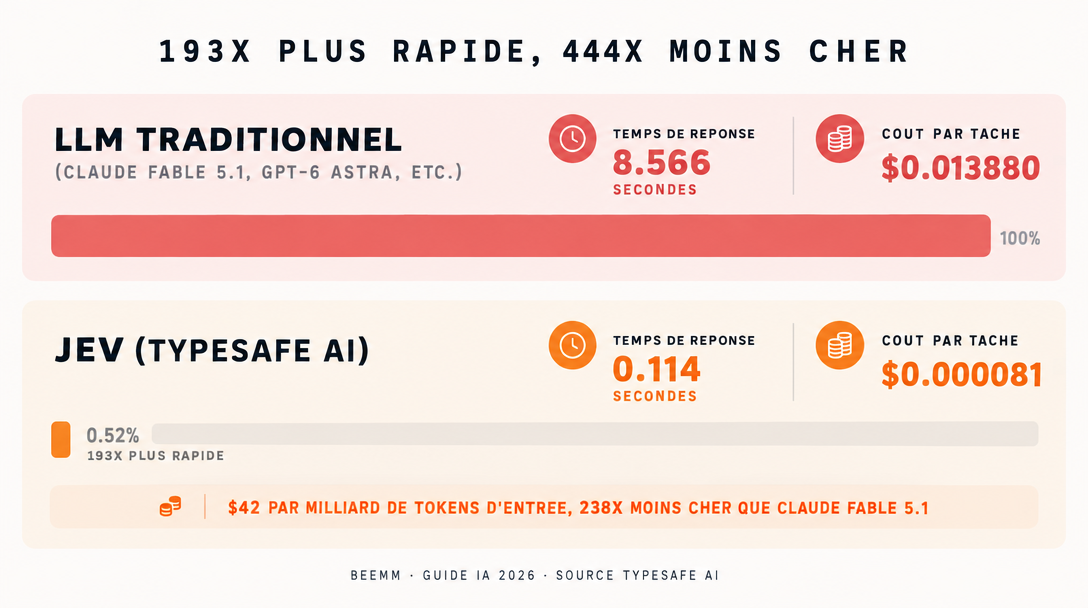
TypeSafe AI publie des benchmarks internes sur des workflows d’automatisation réels. Voici les chiffres bruts :
| Métrique |
LLM traditionnel |
Jev (TypeSafe AI) |
Ratio |
| Temps de réponse |
8,566 secondes |
0,114 secondes |
75x plus rapide |
| Coût par tâche |
$0,013880 |
$0,000081 |
171x moins cher |
| Latence bout-en-bout (System One tasks) |
baseline |
baseline / 193,6 |
193,6x |
| Coût bout-en-bout (System One tasks) |
baseline |
baseline / 444,6 |
444,6x |
| Prix d’entrée par milliard de tokens |
$10 000 (Claude Fable 5.1) |
$42 |
238x moins cher |
Ces chiffres sont communications marketing, pas des benchmarks académiques. Il faut les prendre avec du recul. Mais même en étant charitable (admettons qu’ils sont optimistes par 2), on reste sur des ordres de grandeur qui changent la structure de coût d’une automatisation.
Une tâche de décision qui coûtait $0,014 à 8 secondes devient $0,00008 à 0,1 seconde. Si vous traitez 1 million de décisions par mois (volume typique d’une plateforme SaaS moyenne), vous passez de $14 000/mois à $80/mois. C’est plus un sujet de pricing infra, c’est un sujet d’architecture produit : ce qui était trop cher à automatiser devient trivial.
Ce que ça change pour les devs
Pour un développeur qui intègre Jev dans une pipeline, la vie est radicalement différente.
Avant (LLM classique) :
response = openai.chat.completions.create(
 model="claude-fable-5.1",
 messages=[{"role": "user", "content": f"Classify this email: {email_body}"}]
)
decision = parse_llm_response(response.choices[0].message.content)
# Parse fragile, parfois "SPAM", parfois "spam", parfois "I think it's spam"
# Validation humaine en aval obligatoire
Après (Jev) :
result = jev.decide(
 task="classify_email",
 input={"subject": email.subject, "body": email.body},
 threshold=0.85 # confiance minimale pour action autonome
)

if result.decision == "SPAM" and result.act_autonomously:
 email.move_to_spam()
elif result.probability < 0.5:
 email.move_to_inbox()
else:
 queue_for_review(result)
Le code fait exactement ce qu’il dit. Pas de regex fragile pour parser du langage naturel. Pas de prompt à débuguer à chaque évolution du modèle. Pas de coût caché pour les retries.
Pattern hybride : les LLM restent utiles pour les tâches où la génération de texte est l’objectif (articles, résumés, emails). Les System One Models prennent le relais sur les décisions structurées dans une boucle logicielle. C’est une complémentarité, pas une substitution.
TypeSafe AI le dit explicitement dans leur FAQ : « Jev is built for automation. It’s not a chatbot. » Le positionnement est sans ambiguïté.
Ce que ça change pour le business
Pour une direction technique ou un CDO, la question n’est pas « est-ce que ce modèle est impressionnant ? » mais « qu’est-ce que ça change dans nos coûts et nos produits ? »
Coût marginal qui tend vers zéro. Si vos workflows d’automatisation tournent à 0,1 secondes et $0,00008 par décision, vous pouvez automatiser des cas que vous n’automatisiez pas parce que c’était trop cher. Vérifier chaque transaction. Pré-valider chaque lead. Scanner chaque image uploadée. Cocher chaque edge case en production.
Produit qui se redéploie. Si vous avez une feature « suggestion automatique de tag pour les photos uploadées », elle coûtait $0,014 par photo. À 10 millions de photos uploadées par mois, vous la facturiez ou vous la coupiez. À $0,00008, vous pouvez la donner. Le produit change de nature : ce qui était premium devient commodité.
Décisions qui peuvent se prendre en bord de chaîne. Une IA à 0,1 seconde peut tourner dans une requête API sans attente. Une IA à 8 secondes doit être asynchrone, avec un système de callback, une UI qui montre un loader. La latence change la forme du produit.
Risque de supplier lock-in qui baisse. Si les System One Models deviennent une commodité (et la publication ouverte de Jev va dans ce sens), le marché va se structurer. Prix à la baisse. Choix qui augmente. C’est une bonne nouvelle pour les acheteurs, une mauvaise pour les vendors installés.
Les limites à connaître
Soyons honnêtes : Jev est un premier modèle. Il a des limites à comprendre avant de l’adopter en production.
Modèle spécialisé, pas généraliste. Jev est optimisé pour des tâches de décision structurées. Pour chatter, résumer, brainstormer, un LLM classique reste supérieur. La thèse de TypeSafe n’est pas « les LLM sont morts », c’est « les LLM ne sont pas le bon outil pour l’automatisation ».
Catalogue de tâches à découvrir. TypeSafe AI ne dit pas explicitement quelles tâches Jev sait faire hors de la boîte. Le site liste quelques exemples (classification, scoring, validation) mais sans catalogue structuré. C’est un point à creuser avant d’investir.
Pas encore de standard industriel. Jev est le premier System One Model public. OpenAI, Anthropic, Google n’ont pas annoncé d’équivalent. Le risque de construire sur un produit solo est réel. À surveiller : est-ce qu’un acteur majeur (OpenAI ?) sort un « GPT-Decision » ou « Claude-Decide » dans les 12 mois ?
Pas de garantie de souveraineté. Les données traversent l’API TypeSafe. Pour des cas sensibles (santé, défense, finance à régulation stricte), c’est un blocage juridique. Il faudra attendre une option on-prem ou un concurrent européen.
Confiance dans la calibration. TypeSafe promet une calibration parfaite. C’est leur produit, ils ont intérêt à le présenter ainsi. Il faudra benchmarker sur vos propres données avant de croire.
Pourquoi c’est le futur (la thèse)
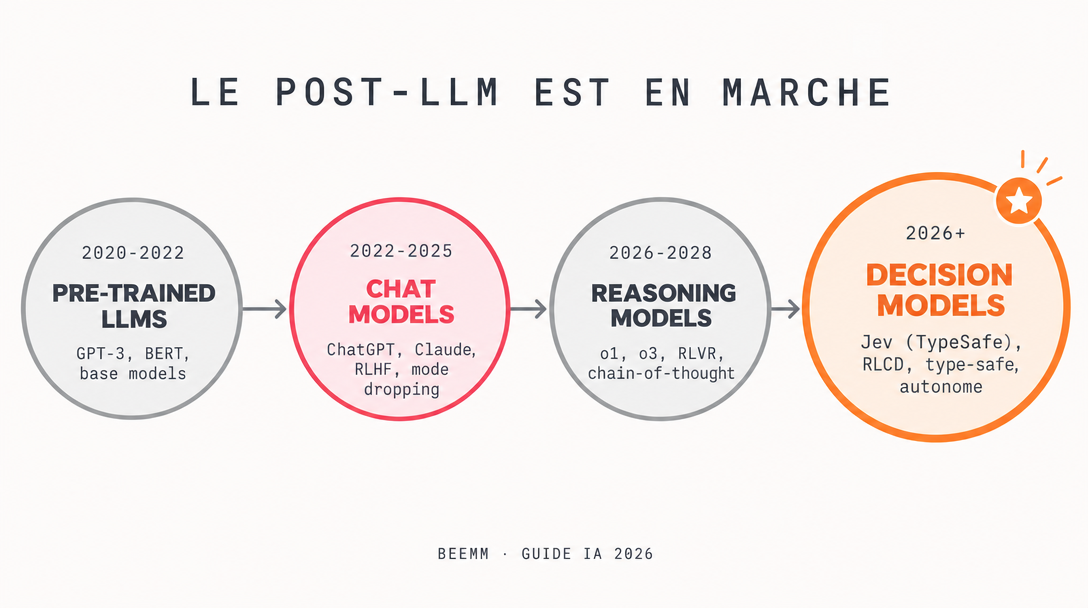
Voici la prédiction que je fais en lisant l’annonce de TypeSafe AI : dans 24 mois, les LLM chat-style vont devenir une couche d’interface, pas une couche d’automatisation.
Le pattern actuel est intenable. On a construit des produits entiers sur des API LLM « intelligentes », en acceptant :
- 10 à 30% de réponses à reprendre à la main
- un coût marginal élevé qui bloque la scalabilité
- une latence incompatible avec le temps réel
- une dépendance à un vendor qui peut changer ses prix demain
Ces produits vont devoir évoluer. Et la voie d’évolution, c’est exactement ce que TypeSafe propose : des modèles spécialisés, rapides, type-safe, avec confiance calibrée, branchés en bord de chaîne, à coût marginal tendant vers zéro.
Le « post-LLM » ne veut pas dire la fin des LLM. Ça veut dire la fin du monopole des LLM sur la décision automatisée. Les LLM restent rois pour la génération. Les System One Models prennent la couronne pour la décision.
C’est la même évolution qu’on a vue dans les bases de données : PostgreSQL n’a pas tué MongoDB. Chaque outil a pris sa niche. Les System One Models sont le « PostgreSQL de la décision automatisée » : moins sexy que le LLM chat, mais 100x plus fiable pour ce qu’il fait.
Ce qu’on en pense chez Beemm
On n’a pas encore accès à Jev (waitlist en cours). Mais on suit ça de près, parce que ça recoupe directement les sujets qu’on traite chez nos clients.
Pour les workflows d’automatisation industrielle (scoring de leads, classification de tickets support, validation de contenus générés, modération) : un System One Model change la donne. Coût x400, latence x75, zéro hallucination, type-safe. Si TypeSafe tient ses promesses, c’est un « avant/après » dans l’architecture produit.
Pour les workflows de génération (articles, images, vidéos, code créatif) : les LLM restent le bon outil. Pas de raison de changer.
Pour les workflows hybrides (génération + validation dans la même chaîne) : on mixera LLM + Jev. Le LLM génère un brouillon, Jev le valide et flag les cas ambigus pour revue humaine. C’est le pattern qu’on commence à recommander chez nos clients en formation.
Notre conviction : dans 18 mois, le réflexe « quel LLM j’utilise ? » va être remplacé par « quel LLM je prends pour la génération, quel System One Model je prends pour la décision ? ». TypeSafe AI vient de poser la première pierre publique de ce second pilier. Il y aura d’autres acteurs, d’autres modèles, probablement des forks open-source. Mais la direction est prise.
Récap en 5 points
| # |
Vérification |
À retenir |
| 1 |
Paradigme |
System One (décision) ≠ System 2 (texte). Deux outils, deux usages. |
| 2 |
Sortie |
Décision typée + probabilité calibrée + seuil d’action. Pas du texte. |
| 3 |
Coût |
$42 / milliard tokens d’entrée, 444x moins cher qu’un LLM classique bout-en-bout. |
| 4 |
Vitesse |
0,1 seconde par décision, 193x plus rapide que le LLM sur System One tasks. |
| 5 |
Fiabilité |
Zéro hallucination (par construction type-safe), confiance calibrée. |
Les outils Beemm pour passer à l’action
Au-delà de cet article, Beemm a développé des produits qui matérialisent ce qu’on décrit ici :
Et si vous voulez former vos équipes sur ces sujets, notre formation dédiée aux modèles d’IA et leur intégration est finançable OPCO (Qualiopi). 500+ personnes formées, 300+ projets livrés.
👉 Réserver un atelier IA pour vos équipes - réponse sous 24h.
Pour aller plus loin
Articles qui complètent celui-ci :

Sources et références
- TypeSafe AI, Introducing System One Models & Jev, 15 septembre 2026 - annonce officielle, prix, benchmarks.
- TypeSafe AI, The Bitterest Lesson - manifeste de recherche, critique du paradigme RLHF.
- TypeSafe AI, AI: too good to be true, too bad to be useful - position philosophique sur les limites des LLM pour l’automatisation.
- Kahneman, Thinking, Fast and Slow, 2011 - référence System 1 / System 2.
- Beemm, Retour d’usage interne - analyse basée sur la documentation publique TypeSafe AI, à confronter à un benchmark indépendant dès l’accès à l’API.
Article rédigé par l’équipe Beemm : Guic (Co-fondateur & AI, ex-Stellantis 23 ans), Samy (CEO & Chief Creative Technologist), Jaja (Co-fondateur & Sales/Growth), Frat (Co-fondateur & Marketing). Dernière mise à jour : 16 septembre 2026.