Le modèle est une commodité. Le harness est la marge.
Le prix d'un niveau de performance IA a chuté de 725× en 18 mois. Le modèle est devenu une commodité, et ce qui crée la valeur en 2026, c'est le harness qui l'orchestre : contexte, outils, mémoire, garde-fous, observabilité. Trois cas pour le prouver.
Le modèle est une commodité. Le harness est la marge.
TL;DR — Un niveau de performance IA donné coûte 725× moins cher qu’il y a dix-huit mois, et le prix de la « pensée » baisse d’environ 13× par an depuis 2023. Le modèle n’est plus le sujet : il est devenu une brique interchangeable. Ce qui distingue désormais un produit IA qui marche d’une démo, c’est le harness — le contexte, les outils, la mémoire, les garde-fous, l’observabilité, la boucle d’amélioration. Le modèle fait 20 % du travail. Le harness fait les 80 % restants, et c’est là que se crée la marge.
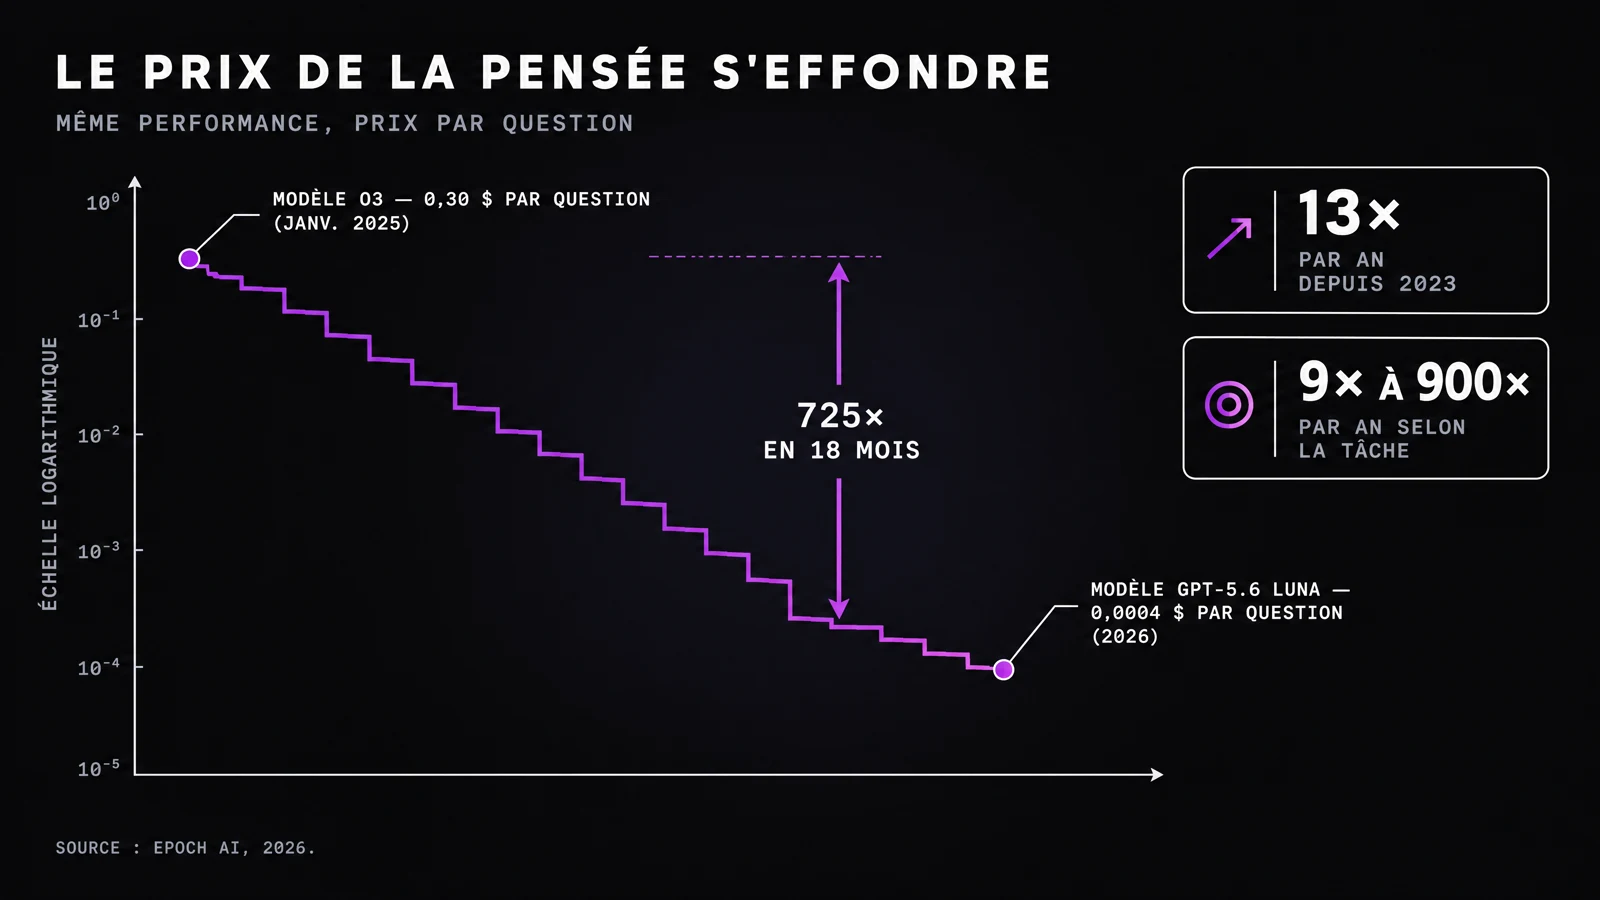
En janvier 2025, obtenir 75 % sur GPQA Diamond — le benchmark de questions niveau doctorat — coûtait environ 30 centimes par question avec o3. Dix-huit mois plus tard, le même score s’obtient pour 0,0004 $. Soit 725 fois moins cher.
Ce chiffre ne fait pas que réduire une facture d’API. Il déplace la valeur de tout un secteur : le modèle — ce qu’on appelait encore « l’IA » il y a deux ans — est en train de devenir une brique interchangeable. Et quand une brique devient interchangeable, elle cesse d’être le produit. Elle devient un coût d’infrastructure, comme l’électricité ou la bande passante.
Nous passons nos journées à construire ces systèmes, chez Beemm comme chez nos clients. Voici ce que les chiffres disent, et ce qu’ils impliquent concrètement pour ceux qui financent, achètent ou vendent de l’IA.
1. Le modèle s’est démocratisé. Et c’est une bonne nouvelle.
Regardons les faits, pas les impressions. D’après les travaux d’Epoch AI, le coût nécessaire pour atteindre un niveau de performance donné baisse d’environ 47 % par trimestre depuis 2023, soit un facteur 13× par an. Pour situer l’ordre de grandeur : c’est 4× plus rapide que la chute des coûts du séquençage de l’ADN, 6× plus rapide que celle du calcul informatique, 18× plus rapide que celle des batteries lithium-ion, et 54× plus rapide que celle de l’électricité entre 1900 et 1973.
Sur la performance de pointe, la baisse a été encore plus brutale : environ 66 % par trimestre au plus fort de la vague des modèles de raisonnement, soit un facteur 75 par an, avant de se tasser vers un facteur 4,7 par an — la courbe ralentit, elle ne s’inverse pas. Et cette chute n’est pas homogène : selon la tâche, Epoch mesure des baisses allant de 9× à 900× par an, avec une médiane autour de 50× par an.
Autrement dit : le prix de la « pensée » s’effondre, et il s’effondre plus vite que celui de n’importe quelle technologie transformatrice du siècle dernier.
La conséquence est mécanique. Il y a encore un an, la qualité du modèle justifiait à elle seule un produit : « nous utilisons le meilleur modèle » était un argument commercial. Aujourd’hui, six familles de modèles frontier se tiennent dans un mouchoir de poche, les écarts se mesurent en points de pourcentage sur des benchmarks qui saturent, et l’écart de prix entre le meilleur et le très bon se compte en centimes par million de tokens.
La bonne nouvelle : plus personne n’a besoin de lever 100 millions d’euros pour accéder à une intelligence de niveau frontier. Une équipe de trois personnes y accède aujourd’hui pour le prix d’un abonnement mensuel. Le ticket d’entrée a disparu.
La mauvaise nouvelle est exactement la même : votre concurrent y accède aussi.
Le modèle, c’est le moteur de course. Tout le monde a le même. Ce qui fait gagner la course, ce sont les réglages, le châssis, la télémétrie et le pilote. En IA, cet ensemble porte un nom : le harness.
2. Anatomie d’un harness : sept pièces qui font la différence
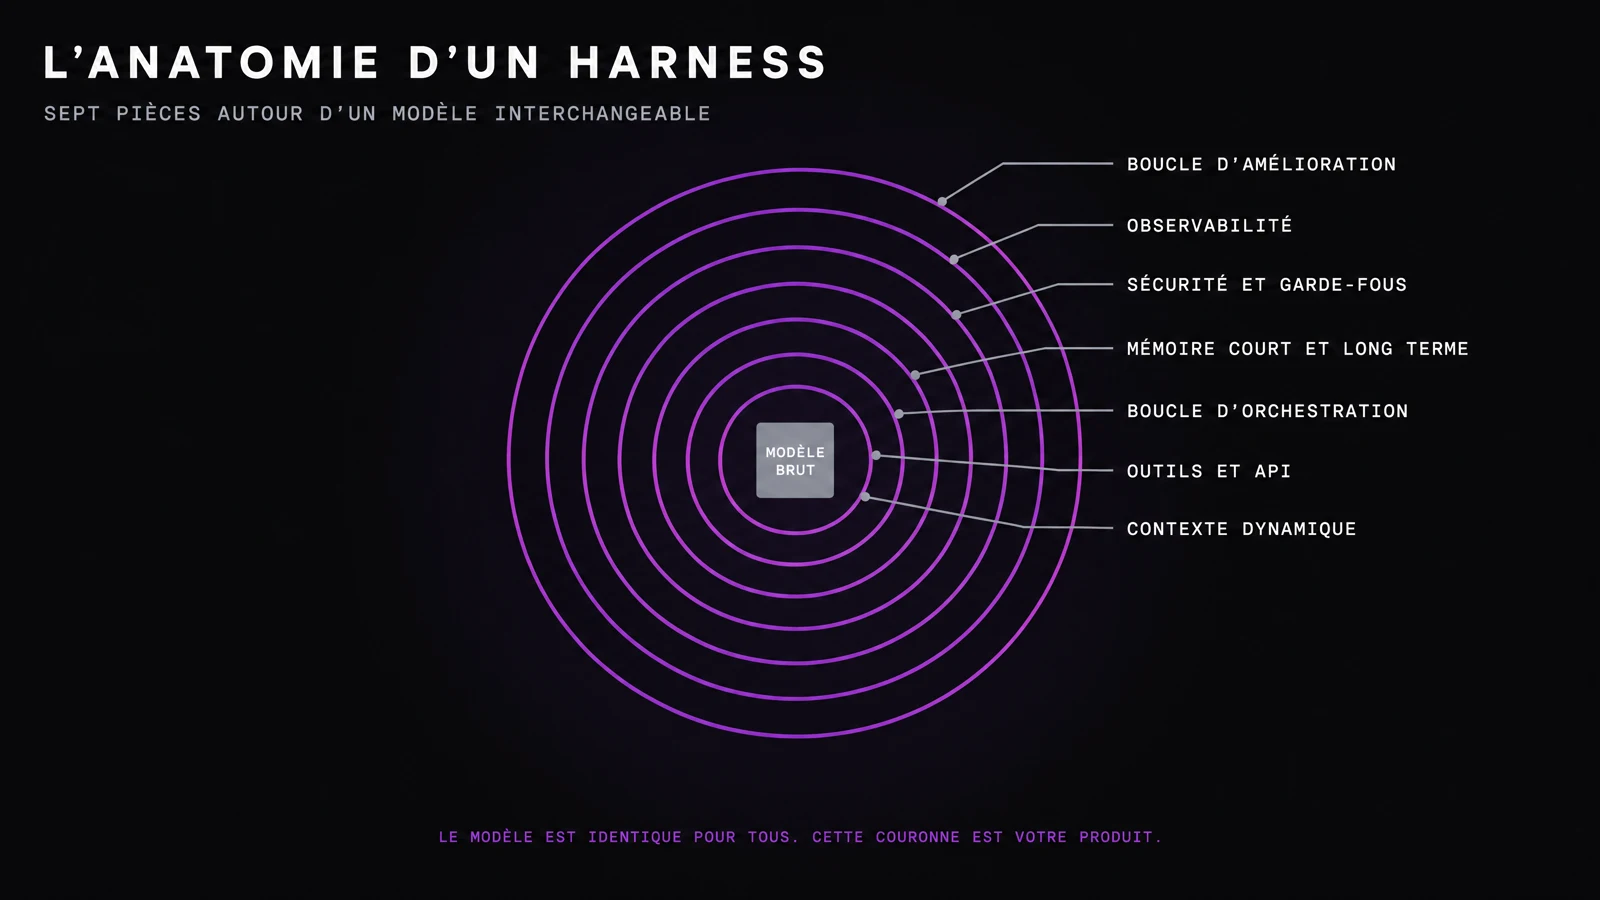
Le mot commence à circuler sérieusement. Un harness, c’est l’ensemble du code et de l’architecture qui entoure le modèle et le transforme en système utilisable. Concrètement, il se décompose en sept pièces.
1. Le contexte
Le modèle ne sait rien de votre métier. Tout ce qu’il sait, c’est ce que vous mettez dans la fenêtre au moment où vous l’appelez. Les instructions système, les données de l’utilisateur, l’historique de la conversation, les documents internes fragiles : la manière dont ce contexte est assemblé, ordonné, compressé et versionné détermine la qualité de la réponse bien plus que le nom du modèle choisi.
2. Les outils
Un modèle qui ne peut pas agir se contente de raconter. Un harness lui donne des outils : rechercher un produit dans un catalogue, appeler une API de stock, écrire dans une base, envoyer un email, exécuter un script. Toute la difficulté est dans la robustesse : que se passe-t-il quand l’API rend une erreur, quand le résultat est vide, quand l’outil répond en trois secondes ou en trente ? Les outils et leurs garde-fous sont la partie immergée du métier.
3. La boucle d’orchestration
Un appel unique au modèle, c’est une démo. Un système, c’est une boucle : planifier, appeler un outil, observer le résultat, corriger la trajectoire, recommencer — en sachant quand s’arrêter. Cette boucle, avec ses seuils, ses budgets de tokens, ses conditions de sortie et ses points de reprise, est du code qu’il faut écrire, tester et surveiller. C’est aussi la partie qui casse le plus vite quand on monte en charge.
4. La mémoire
Un assistant qui redemande à chaque fois le nom du client n’est pas un assistant, c’est un formulaire. La mémoire a deux étages : la mémoire courte, qui tient le fil d’une tâche, et la mémoire longue, qui accumule préférences, historique et faits durables. La difficulté n’est pas de stocker — c’est de décider quoi retenir, quand oublier, et comment retrouver l’information pertinente sans polluer le contexte.
5. La sécurité et les garde-fous
Un modèle qui a accès à vos données et à des outils qui écrivent est un risque opérationnel. Le harness est l’endroit où l’on décide ce que le système a le droit de faire : quel outil peut écrire, quel seuil déclenche une validation humaine, comment on empêche une donnée d’un client de fuir dans la réponse à un autre, comment on journalise ce qui a été fait et par qui. C’est ingrat à construire, invisible en démonstration, et c’est précisément ce qu’un auditeur ou un client grand compte vérifiera en premier.
6. L’observabilité
Un système probabiliste se dégrade en silence. Sans traces, sans évaluations automatiques, sans mesure de latence et de coût par tâche, on ne sait pas si le système s’améliore ou s’effondre. L’observabilité n’est pas un luxe de grand groupe : c’est ce qui permet de détecter une régression après un changement de prompt ou une mise à jour de modèle, sans attendre qu’un client s’en plaigne.
7. La boucle d’amélioration
Enfin, il y a ce qui transforme un prototype en produit : la capacité à itérer sur la base de cas réels. Un jeu d’évaluations qui grandit à chaque anomalie rencontrée, une bibliothèque de prompts versionnée, des corrections capitalisées. C’est l’actif qui s’accumule, et c’est exactement ce qu’un modèle loué à l’heure ne vous donnera jamais.
Où passe réellement le travail
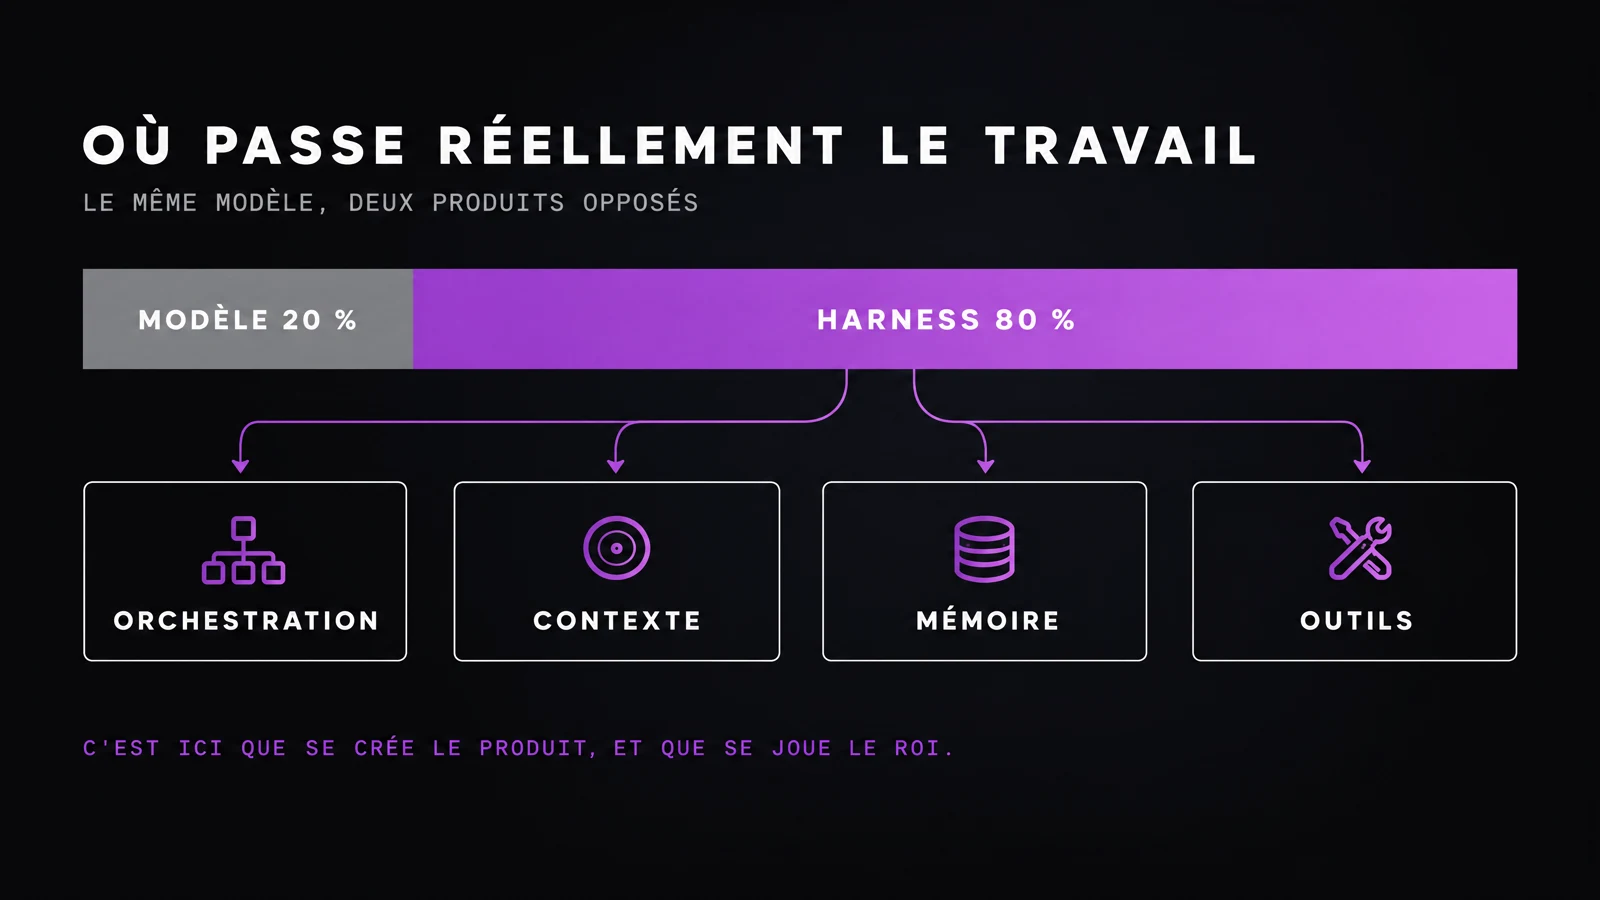
Dans nos projets, la répartition est constante et sans appel : le modèle représente environ 20 % de la valeur, le harness les 80 % restants. Les 20 % sont la partie que tout le monde voit et que tout le monde peut acheter. Les 80 % sont la partie que personne ne voit, que l’on n’achète pas au token, et qui décide si le système tient en production.
C’est aussi le sens de la mesure que nous suivons dans nos déploiements : le coût du modèle baisse de 13× par an, le coût du harness, lui, suit la courbe du travail humain expérimenté. C’est une asymétrie difficile à renverser.
3. Trois cas concrets, pour que ce soit moins abstrait
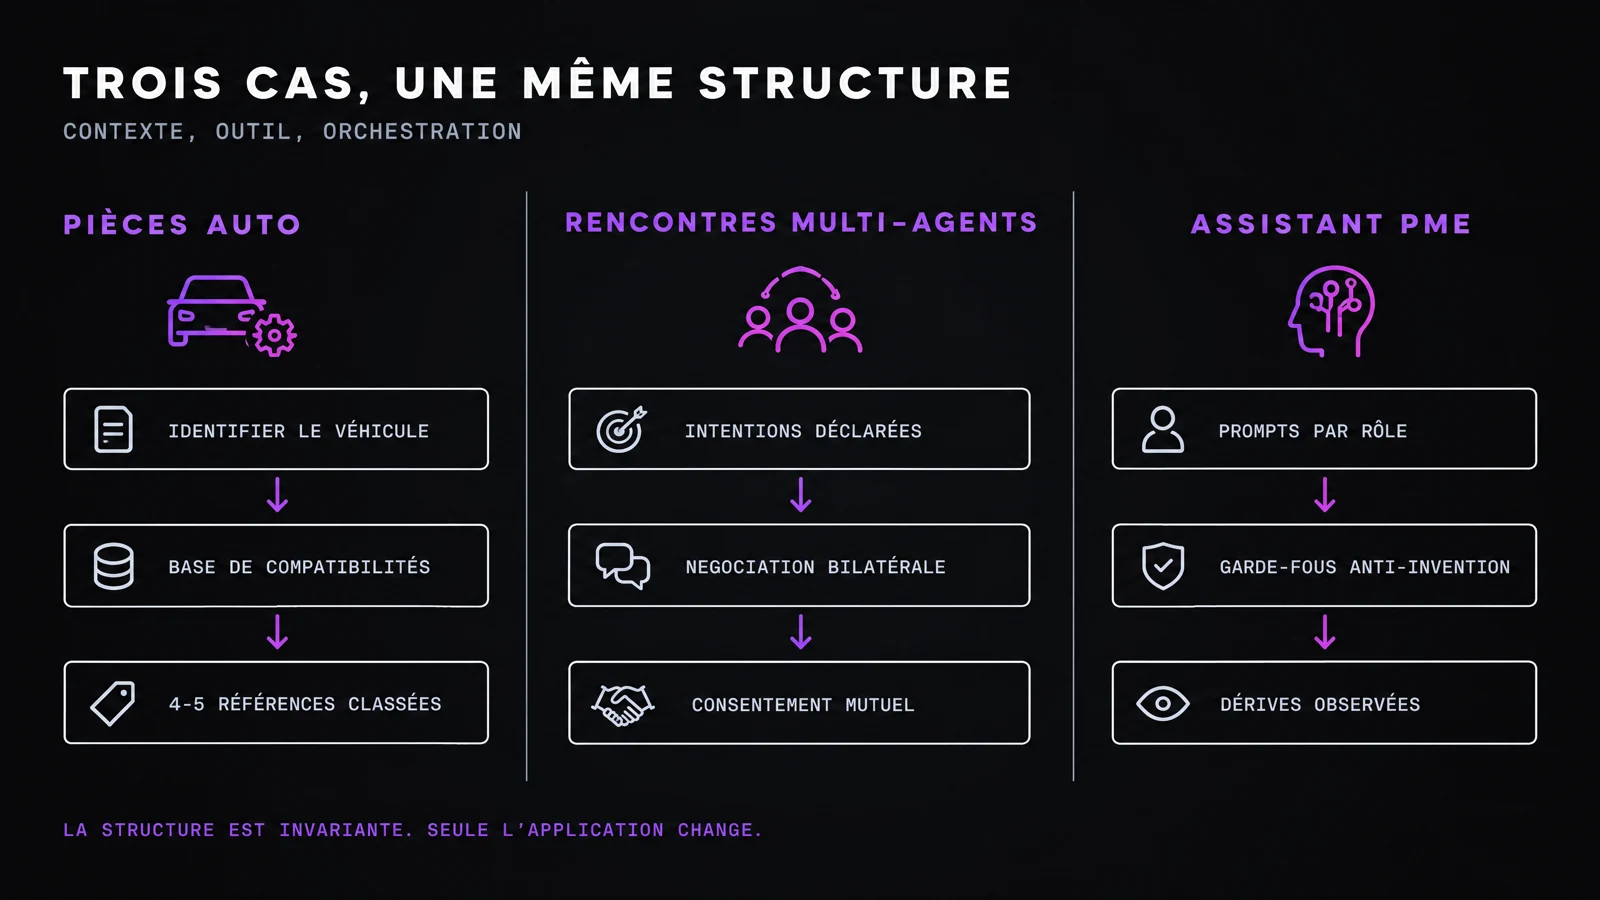
La théorie est élégante, la production est cruelle. Voici trois systèmes sur lesquels nous avons travaillé ou que nous opérons, avec la même structure : contexte, outils, orchestration.
Cas 1. Un moteur de recherche qui comprend « plaquettes de frein pour ma Renault Clio »
Le problème : plusieurs millions de références en catalogue, des dizaines de millions de véhicules en circulation, et une majorité d’utilisateurs qui ne trouvent pas la bonne pièce au premier essai. Un numéro de référence ne sert à rien à quelqu’un qui ne sait pas ce qu’il cherche. Et le modèle seul ne résout rien : il ne connaît ni votre stock, ni les compatibilités de la Clio de 2014, ni le prix de votre fournisseur.
Le harness, lui, enchaîne : il identifie le véhicule à partir d’une plaque, d’un modèle ou d’une photo de carte grise ; il interroge la base de compatibilités ; il classe les résultats par équipementier (Brembo, Valeo, Bosch, TRW) ; il présente quatre à cinq références avec prix et délai ; il explique pourquoi telle pièce est recommandée plutôt qu’une autre ; il se souvient du véhicule pour la recherche suivante ; et il remonte dans un tableau de bord ce que les clients cherchent réellement — ce qui constitue, au passage, la meilleure étude de marché que le site produira jamais.
Dans ce système, le modèle fait environ 20 % du travail. Les 80 % restants sont de l’orchestration, du contexte, de la mémoire et des outils. C’est là que se crée le produit, et c’est là que se joue le retour sur investissement.
Cas 2. Un réseau social d’agents qui organisent des rencontres
Deux humains dans un bar. Chacun a un agent personnel. Les agents négocient en amont, selon les intentions déclarées par chaque personne — business, amitié, rencontre — pour décider s’il vaut la peine de faire se croiser leurs humains, et sur quel angle les présenter.
Le modèle seul, ici, est un bavard : il produit des phrases plausibles sur les affinités. Le harness, lui, met en place un protocole de négociation bilatérale avec consentement explicite à chaque étape, une mémoire des interactions passées, des garde-fous stricts (aucun agent ne voit le profil de l’autre avant que les deux humains aient donné leur accord), et une boucle d’apprentissage qui recalibre les suggestions sur ce que chaque personne accepte réellement. Le tout sans qu’aucun humain n’ait à donner son numéro à un inconnu.
C’est le type de produit où la valeur ne réside ni dans le modèle ni dans l’application mobile, mais dans le protocole — c’est-à-dire, encore une fois, dans le harness.
Cas 3. Un assistant interne pour une PME de 30 personnes
On a vu cent versions de ce projet. Elles échouent presque toutes au même endroit : le passage à l’échelle au-delà du créateur.
Le premier utilisateur, c’est l’inventeur du harness. Il sait quoi demander, il sait comment le modèle se trompe, il sait où le recadrer. Le trentième utilisateur, lui, ne sait rien de tout cela — et c’est précisément le moment où le système se casse. Un bon harness embarque donc des comportements par défaut intelligents : des prompts qui s’adaptent au rôle, un contexte qui s’enrichit du poste occupé, des garde-fous qui empêchent l’agent d’inventer un chiffre qu’il ne connaît pas, et une observabilité qui détecte les dérives avant qu’elles ne coûtent cher.
Si vous avez déployé un assistant interne au-delà de vous-même, vous avez vu le moment exact où il s’est cassé. C’est presque toujours à la cinquième ou sixième demande, quand l’utilisateur a oublié qu’il parle à un modèle.
4. Ce que cela change pour qui finance ou achète de l’IA
Quatre conséquences opérationnelles, dans l’ordre d’importance.
Un. Un modèle moyen dans un harness excellent bat un modèle excellent dans un harness moyen. Si vous évaluez une solution IA en 2026 sur le nom du modèle qu’elle utilise, vous évaluez le mauvais objet. Demandez plutôt : quel est son harness, qui l’a conçu, comment est-il observé, comment s’améliore-t-il en production ? Si la réponse est floue, le produit ne tiendra pas six mois — quel que soit le modèle derrière.
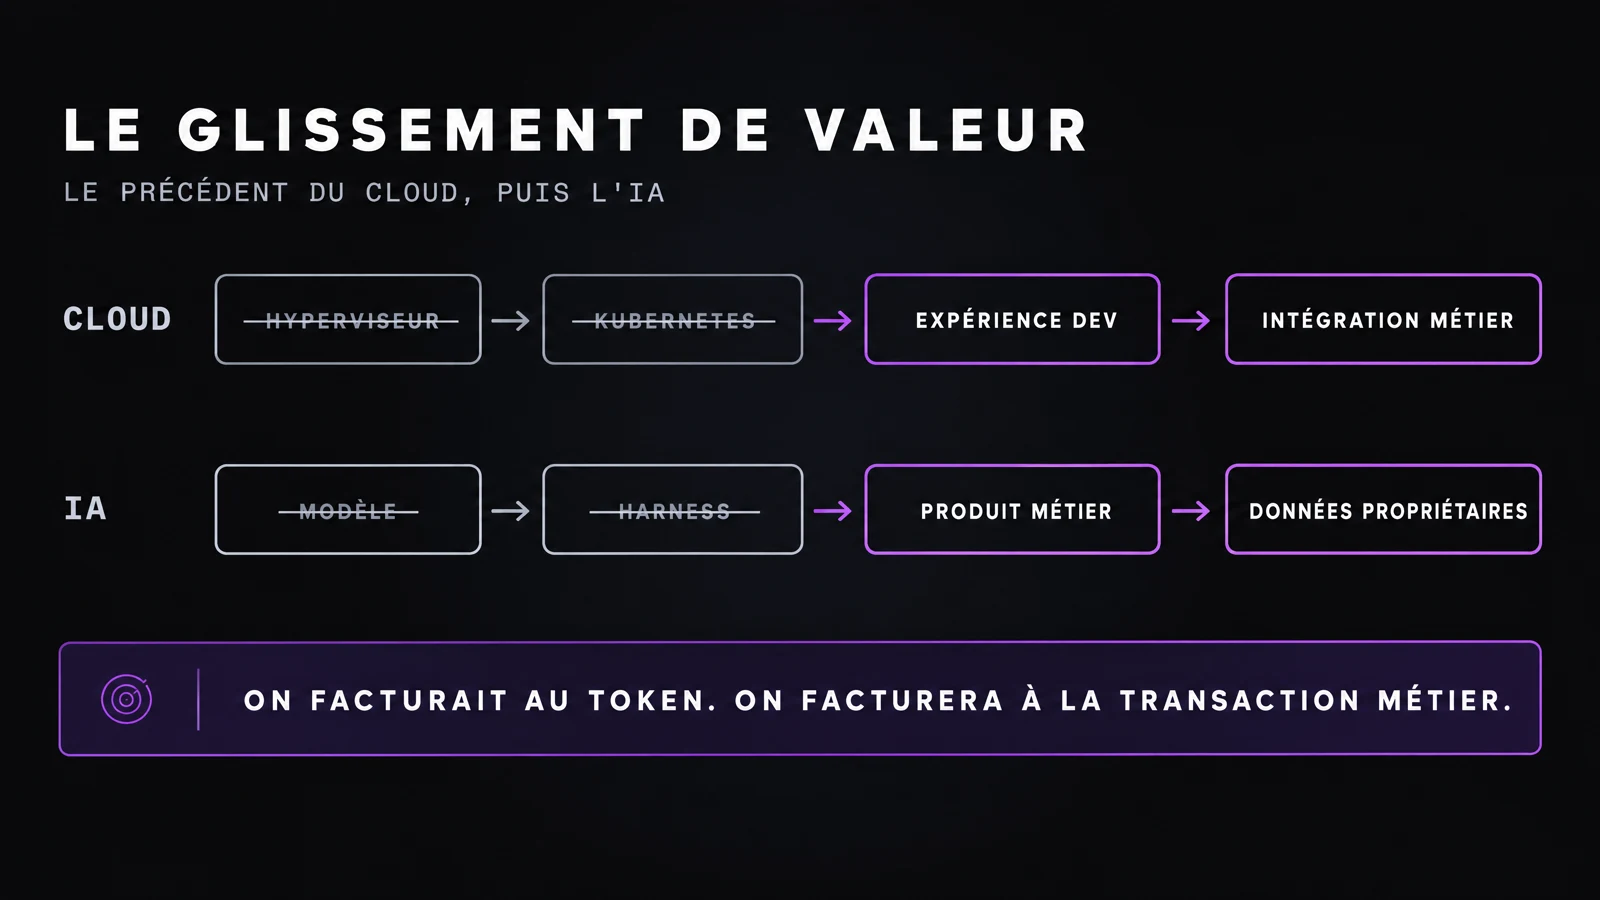
Deux. La valeur se crée à l’intégration, pas à la couche modèle. C’est exactement ce qui s’est passé dans le cloud : les hyperviseurs se sont commoditisés, la valeur s’est déplacée vers l’orchestrateur (Kubernetes), puis vers l’expérience développeur (Vercel, Cloudflare), puis vers l’intégration aux outils métier (Salesforce, SAP). L’IA suit la même trajectoire, avec un décalage qu’il faut avoir en tête : le cloud a mis une quinzaine d’années à parcourir ce chemin, l’IA le parcourt en trois à cinq ans parce que la baisse de prix est bien plus rapide.
Trois. La dette technique d’un mauvais harness est exponentielle. Un prompt bricolé qui marche à la première démonstration devient un piège à la millième requête. Un outil mal décrit devient un faux positif récurrent. Une mémoire qui fuit devient un incident RGPD. Tout ce qui est mal harnaché au début devient ingérable à l’échelle — c’est l’argument pour investir dans le harness dès le premier jour, et pas au quatrième sprint.
Quatre. Le pricing va suivre. Tant que le modèle était rare, on facturait au token. Quand le modèle est commoditisé, on facture à la transaction métier. Vous ne paierez bientôt plus « 1 000 tokens de GPT-5 », vous paierez « un dossier client traité », « un match validé », « un diagnostic produit ». Le prix suit la valeur, et la valeur est dans le harness.
5. Les cinq questions à poser avant d’acheter
Si vous devez évaluer une solution IA demain — un fournisseur, un prestataire, un projet interne — posez ces cinq questions. Aucune ne porte sur le modèle.
- Quel est le contexte dynamique fourni au modèle à chaque appel ? Montrez-le-moi. Pas le prompt système marketing : le contexte réel, assemblé à l’exécution, avec l’état métier dedans.
- Quels outils le modèle peut-il appeler, et comment sont-ils décrits ? Donnez-moi un exemple d’erreur d’arbitrage et la façon dont vous l’avez corrigée.
- Comment est structurée la boucle d’orchestration ? Combien d’agents, qui appelle qui, comment l’échec remonte, à quel moment on s’arrête ?
- Quelle est votre observabilité ? Montrez-moi un tableau de bord de production réel, avec le coût par tâche et la latence.
- Comment le système s’améliore-t-il ? Combien d’évaluations automatiques, à quelle fréquence, et qu’avez-vous corrigé la semaine dernière grâce à elles ?
Un fournisseur sérieux répondra aux cinq en moins de dix minutes. Un revendeur de modèles répondra à la première en parlant du modèle.
Récap en 5 points
| # |
Ce qu’il faut retenir |
Le chiffre |
| 1 |
Le coût d’un niveau de performance donné s’effondre |
13× par an depuis 2023, jusqu’à 725× en 18 mois sur un même benchmark |
| 2 |
Le modèle est une brique interchangeable |
6 familles frontier dans un mouchoir de poche |
| 3 |
La valeur s’est déplacée vers le harness |
20 % modèle, 80 % harness dans nos projets |
| 4 |
Un mauvais harness coûte plus cher qu’un mauvais modèle |
la dette devient exponentielle à l’échelle |
| 5 |
Le prix suivra la valeur, pas le token |
on facture au token, on facturera à la transaction métier |
La question n’est donc pas « quel modèle allons-nous utiliser ». Elle est : « qu’est-ce qu’on construit autour, et qui sait le faire ? »
Ce qu’on en pense chez Beemm
Notre conviction est simple et elle guide nos choix depuis le début : ce qui se commoditise ne mérite ni votre argent ni votre attention. Vous n’achetez pas de l’électricité au kilowatt-heure en croyant acheter votre usine. En IA, c’est pareil — le modèle est le courant, le harness est l’usine.
Concrètement, cela veut dire trois choses dans la façon dont nous travaillons :
- Nous ne vendons pas de modèle, nous construisons des systèmes qui en utilisent plusieurs et basculent de l’un à l’autre quand le rapport performance/prix change. Un produit qui dépend d’un seul fournisseur de modèle n’est pas un produit, c’est une position sur un fournisseur.
- Nous investissons en premier dans le contexte et l’observabilité, parce que ce sont les deux pièces qui font la différence entre un système qui s’améliore et un système qui dérive. C’est moins démonstratif qu’un bel écran de chat, et beaucoup plus rentable.
- Nous mesurons le coût par tâche métier, pas le coût par million de tokens. Le second est un chiffre d’infrastructure, le premier est un chiffre d’entreprise.
Les outils Beemm pour passer à l’action
- Beemm Vision — vos visuels produits générés et harmonisés à la charte, sans photoshoot ni retouche manuelle.
- PhotoBeemm — la production photo et vidéo IA des lieux, hôtels, restaurants et commerces, livrée en batch.
- Notre offre de formation et de coaching — pour apprendre à votre équipe à concevoir un harness propre, du contexte à l’observabilité, sur vos propres cas d’usage.
👉 Réserver un audit de 30 minutes — nous passons en revue votre système, nous identifions où votre harness perd de l’argent, et nous vous disons franchement si un projet vaut le coup.
Pour aller plus loin
Articles qui complètent celui-ci :
Comparatif des harness IA en 2026 : Claude Code, Codex, OpenClaw, DeepSeek Harness — les six harness qui comptent, leurs étoiles GitHub au 7 octobre 2026, leurs forces réelles et la matrice pour choisir le vôtre.
Maîtriser Claude Code en 2026 : Plan Mode, CLAUDE.md, Skills, Hooks et MCP — le guide de mise en œuvre du harness le plus utilisé du lot, du premier CLAUDE.md aux hooks de sécurité.
Sources et références
- Epoch AI, The plunging price of thought, 2026 — baisse du coût pour un niveau de performance donné d’environ 47 % par trimestre depuis 2023 (13× par an), 66 % par trimestre sur la performance de pointe au plus fort de la vague, et comparaison avec l’ADN, le calcul, les batteries et l’électricité. epoch.ai/publications/the-plunging-price-of-thought
- Epoch AI, LLM inference prices have fallen rapidly but unequally across tasks, 2025-2026 — fourchette de baisse de 9× à 900× par an selon la tâche, médiane proche de 50× par an ; indicateurs par benchmark et par niveau de performance. epoch.ai/data-insights/llm-inference-price-trends
- a16z, Welcome to LLMflation — LLM inference cost is going down 10x per year — première formalisation de la baisse annuelle du coût d’inférence. a16z.com/llmflation-llm-inference-cost
- Beemm, retours d’usage interne et missions client, 2026 — répartition constatée 20 % modèle / 80 % harness, coût par tâche métier, cas du moteur de recherche pièces auto, du réseau d’agents et des assistants internes.
- Documentation Anthropic, OpenAI, DeepSeek et OpenClaw — définitions et périmètres du harness, du contexte dynamique et de la boucle d’orchestration.
Article rédigé par l’équipe Beemm : Guic (Co-fondateur & AI, ex-Stellantis 23 ans), Samy (CEO & Chief Creative Technologist), Jaja (Co-fondateur & Sales/Growth), Frat (Co-fondateur & Marketing). Dernière mise à jour : 7 octobre 2026.