Git a été conçu pour des humains. Les agents Ont Scion.
Le 13 octobre, l’équipe source control d’Anthropic a publié un post d’ingénierie qui raconte une décision simple à énoncer et difficile à avaler : git ne passe plus, dans leur monorepo. Scion, leur système maison, l’a remplacé en cinq mois. Entre mai et septembre 2026, le nombre de changements fusionnés par jour est passé d’environ 2 500 à plus de 30 000.
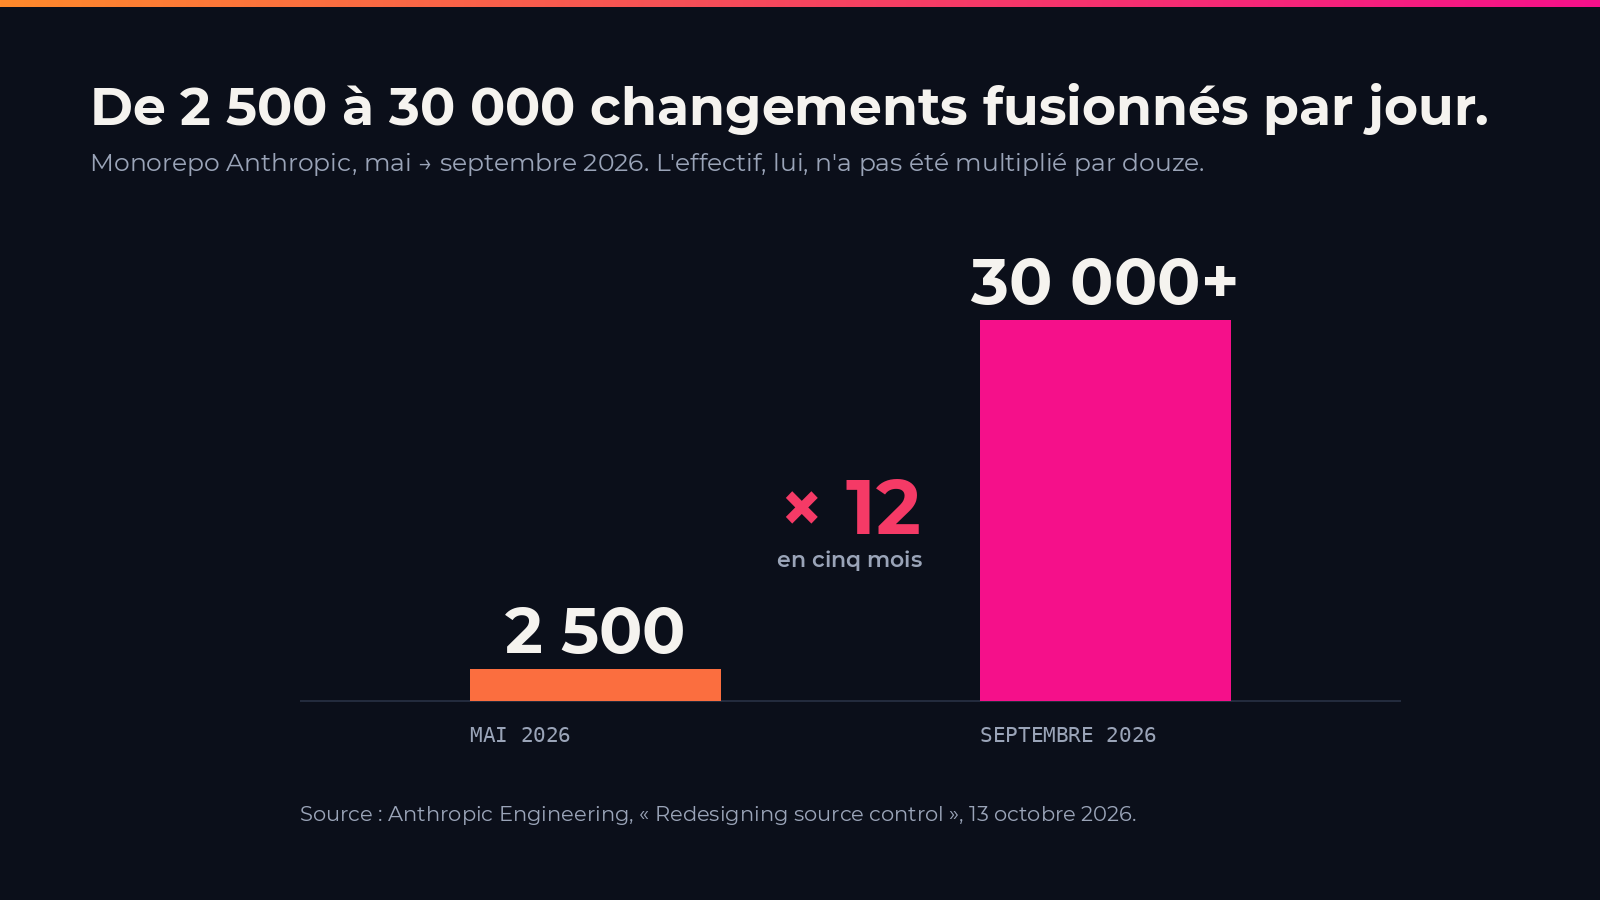
La lecture paresseuse de cette annonce, c’est « Anthropic tue git ». C’est faux sur tous les plans. Scion n’est pas open source, n’est pas un produit, ne sera pas distribué, et Anthropic écrit noir sur blanc que ce n’est pas un substitut à git pour un usage normal. La vraie information est dans le chiffre, et dans ce qu’il annonce pour les six prochains mois : le goulot d’étranglement a quitté le modèle pour s’installer dans la plomberie qui transporte ce que le modèle produit.
1. L’idée reçue : l’IA se joue dans le modèle
Depuis deux ans, la conversation sur l’IA est une conversation de modèles. Le plus grand, le plus rapide, le moins cher au million de tokens. C’est une conversation de vitrine, et elle occupe tout l’espace parce qu’elle est facile à filmer.
Le jour où des agents écrivent une part significative du code, la question change de nature. Un humain produit quelques commits par jour. Un essaim d’agents en produit des milliers, et chaque commit déclenche une chaîne : revue, tests, build, déploiement, parfois plusieurs environnements. Le modèle continue de répondre en quelques secondes. C’est le reste qui n’encaisse pas.
L’analogie la plus juste est celle du péage. Imaginez que chaque voiture doive transporter sa propre copie de la carte du réseau avant de pouvoir passer. À 2 500 véhicules par jour, personne ne s’en aperçoit. À 30 000, il faut agrandir les routes. À 25 millions de passages quotidiens côté intégration continue, la carte pèse plus lourd que le trafic qu’elle est censée décrire.
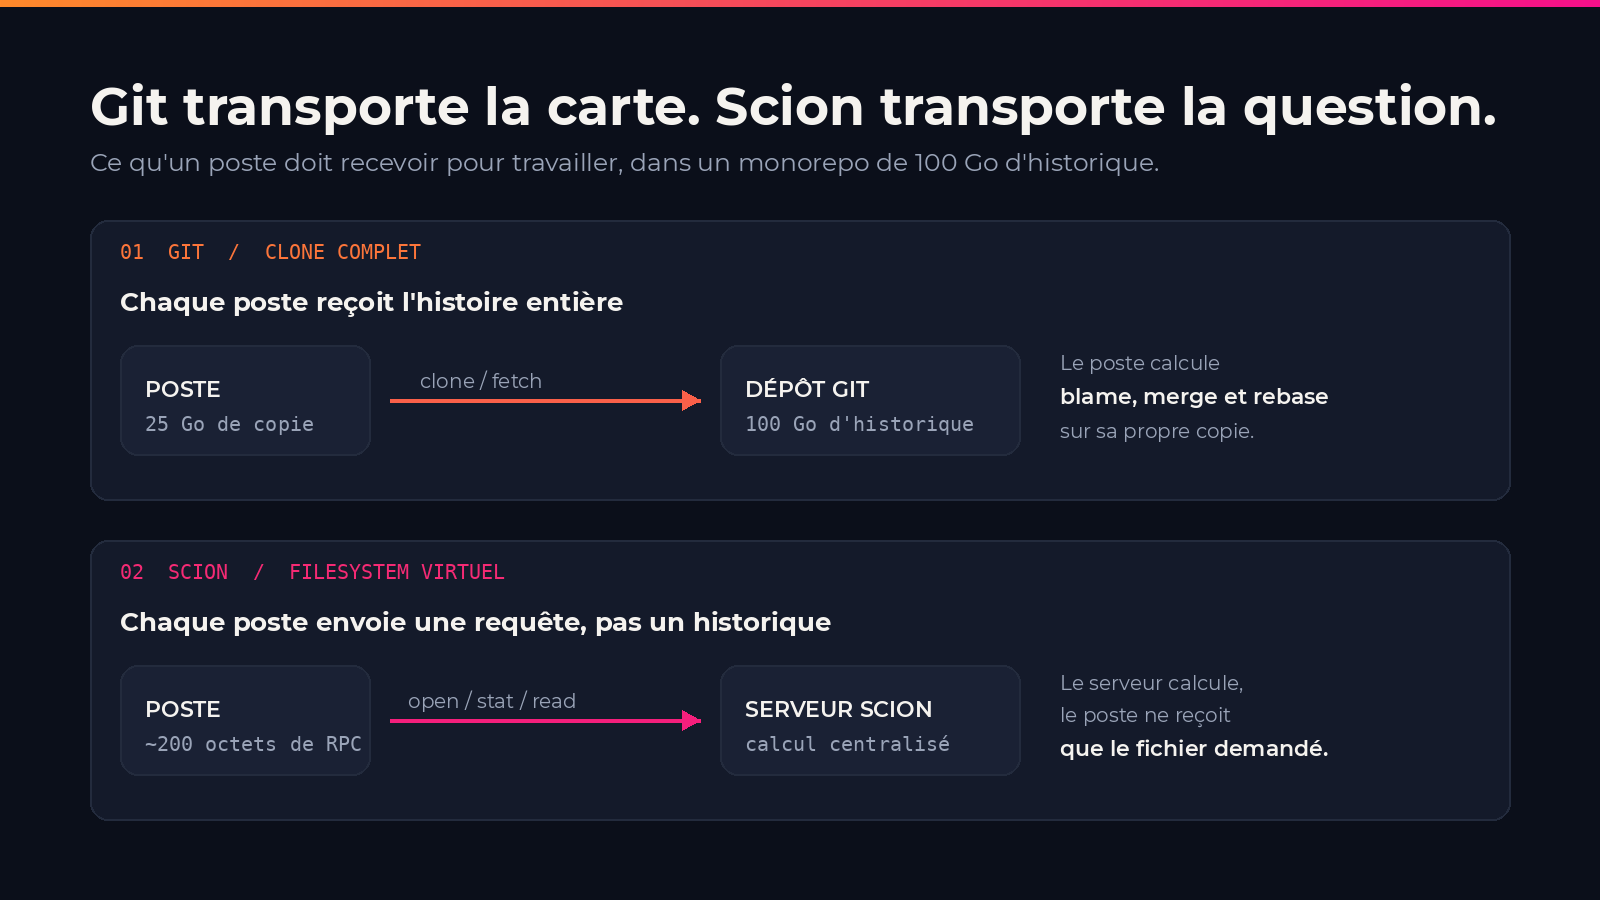
C’est exactement le modèle de git. Chaque client possède l’historique complet, parce que git a été dessiné pour un monde décentralisé, avec des développeurs qui travaillent hors ligne et se synchronisent de temps en temps. Anthropic décrit un monde inverse : un dépôt unique, énorme, consulté presque exclusivement par des clients connectés en permanence. Des agents, des jobs d’intégration continue, des environnements de développement qui vont et viennent.
Les chiffres du monorepo donnent le vertige. Plus de 100 Go d’historique sur la branche principale, une copie de travail compressée au-delà de 25 Go, et environ 25 millions de checkouts par jour rien que pour la CI. Si chaque checkout téléchargeait tout naïvement, le trafic git dépasserait 600 Po par jour. Anthropic a tenu pendant des années avec les rustines habituelles : clones superficiels, checkout partiel, promisor remotes, miroirs internes, copies d’amorçage dans le stockage objet. Au pic, plusieurs centaines de miroirs git, de plus en plus durs à maintenir à mesure que les fusions grimpaient. Les copies d’amorçage prenaient du retard sur la tête de main. Le diff et le blame sur des clones partiels devenaient des puzzles.
Rien de tout cela ne dit que git est mauvais. Cela dit qu’un outil conçu pour une certaine échelle devient une dette quand l’échelle change d’un ordre de grandeur en cinq mois.
2. Six décisions qui déplacent le calcul
Scion n’est pas une réécriture de git avec de meilleures performances. C’est une autre hypothèse de départ. Voici les six pièces qui portent cette hypothèse.
L’unité de travail n’est plus le commit
Un commit git pointe vers un arbre complet. Un changeset Scion est une ligne d’un journal en écriture séquentielle : la liste des fichiers modifiés par rapport au premier parent, et un pointeur vers le contenu compressé dans le stockage objet, adressé par un hash calculé à partir du contenu lui-même. La conséquence est discrète mais décisive : l’historique, le blame et les autres index deviennent des données dérivées, recalculables en remontant les parents. Anthropic peut changer l’intérieur sans toucher aux outils des développeurs.
Le transfert part de la racine, pas du client
En git, le client annonce ce qu’il possède déjà et le serveur prépare un packfile avec la différence. Sur un dépôt de cette taille, ce packfile pèse plusieurs gigaoctets. En Scion, le client part de l’arbre racine et descend, demandant uniquement les répertoires et fichiers dont il a besoin. La réponse est petite et reprend là où elle s’est interrompue si le réseau lâche.
Le calcul passe côté serveur
Blame, fusion, rebase : plus rien ne se calcule localement. Le serveur le fait et l’expose par API. Il n’y a plus de rebase local suivi d’un push, parce qu’il n’y a plus de push.
Les références deviennent l’exception
Git laisse créer autant de branches et de tags qu’on veut. Scion les décourage, sauf pour main et les releases. Elles sont mises à jour par un compare-and-swap sur une seule ligne de Spanner, séparément de la création du changeset. Comme les données sont immuables, n’importe quel serveur peut les mettre en cache sans se coordonner avec les autres.
La copie de travail est optionnelle
Le client matérialise les fichiers à la demande. Pas de copie complète, pas de sparse checkout à configurer à la main, pas d’arbitrage entre temps de clone et espace disque.
Le hors-ligne est abandonné
C’est le prix, et il est explicite. Scion suppose un serveur autoritaire et des clients connectés en permanence. Sans réseau, il n’y a pas de travail.
Sous le capot, trois composants parlent les mêmes RPC : un démon qui tourne sur chaque nœud et démarre depuis un snapshot rafraîchi en continu, des caches régionaux qui servent les objets depuis la mémoire, et des serveurs autoritaires qui lisent Spanner ou le stockage cloud. La hiérarchie est rigide volontairement, pour qu’un cache régional en difficulté ne déverse pas son problème sur les couches supérieures.
Les résultats annoncés sont spectaculaires : plus de 99 % de taux de succès de cache à chaque niveau, une infrastructure 200 fois plus petite en CPU et en mémoire que les anciens miroirs git, des checkouts en secondes plutôt qu’en minutes, et 25 % de capacité CPU économisée sur la CI. Ce sont des chiffres internes, invérifiables de l’extérieur. Il faut les prendre pour ce qu’ils sont : une promesse d’ingénieur, pas un benchmark public. Le point de contrôle est simple : si le taux de cache descend sous 95 % ou si un checkout dépasse la minute, l’architecture coûte plus qu’elle ne rapporte.
3. Trois cas, dont deux qui nous concernent
Anthropic, d’abord. Le projet a été mené par une équipe de sept personnes. Fait notable : Claude a écrit une partie du système. Un prototype artisanal du pipeline d’import d’historique depuis git a été réécrit par Mythos Preview, avec 20 fois moins de mémoire et 4 fois plus de vitesse, en conservant les invariants implicites du code d’origine. Le travail des ingénieurs a changé de nature : ils posent l’architecture et les contraintes, arbitrent, et disent non quand le modèle propose une solution qui casse une contrainte ou sur-ingénierie le problème. La revue passe de l’inspection de chaque ligne à la vérification de l’intention du changement.
Beemm Vision, ensuite. Nous vivons une version plus modeste du même déplacement. Sur un déploiement comme Pathé Studio, la plateforme orchestre plusieurs fournisseurs de génération d’images et de vidéos. Ce qui casse en premier n’est jamais le modèle : sur quatre générations demandées, deux reviennent parfois, et la semaine se passe à corriger les files fournisseurs, les timeouts et les coûts Firebase. Ajoutez les droits par équipe et la traçabilité de qui a généré quoi avec quel prompt, et vous obtenez le même goulot, à une autre échelle.
Hirnao, enfin. Même bascule sur un réseau où des agents se parlent pour provoquer des rencontres humaines. La contrainte n’est pas la puissance des modèles. Elle est dans le routage, la confiance entre agents, la capacité à rejouer un échange et à expliquer pourquoi deux personnes se sont retrouvées à la même table. Dès que le volume monte, l’infrastructure de coordination devient le produit.
Le contrepoint compte autant. Une PME de trente personnes avec un dépôt de quelques gigaoctets n’a aucun de ces problèmes, et git reste le bon outil. Anthropic le dit elle-même : Scion ne convient qu’aux monorepos géants avec des dizaines de milliers d’ingénieurs ou des essaims d’agents. Aucun code n’a été publié. La société cite Google Piper et le client Sapling de Meta, open source depuis 2022, parmi ses inspirations. Ce qui est nouveau n’est pas l’idée du dépôt centralisé. C’est celui qui pousse le changement : le volume de code produit par des agents.
4. Ce que vous devez mesurer dès maintenant
Cinq actions, dans l’ordre. Elles recoupent ce que nous observons dans notre comparatif des harness IA : le modèle n’est presque jamais le facteur limitant.
Mesurez votre débit, pas votre modèle. Nombre de changements par jour, nombre de checkouts, temps de bout en bout entre l’idée et la production. Si ces courbes montent plus vite que votre équipe, le goulot est déjà ailleurs.
Cherchez la ressource à copie complète. Historique, index de recherche, cache d’embeddings, base de test. Tout ce que chaque client duplique en entier est un candidat à la casse.
Déplacez le calcul là où sont les données. Un client qui recalcule localement ce que le serveur sait déjà paie deux fois : en temps et en cohérence.
Traitez les droits par objet, pas par dépôt. Anthropic gère les permissions par dépôt et par répertoire, avec des approbations qui portent des contraintes sémantiques : un changement qui ne touche que des commentaires n’est pas un changement qui modifie la logique. C’est le niveau de granularité qu’attend une DSI.
Assumez ce que vous perdez. Scion abandonne le hors-ligne. Ce n’est pas un détail, c’est un choix d’organisation. Si vous copiez l’architecture sans copier la décision, vous héritez du pire des deux mondes.
Un dernier point, moins technique. Anthropic a renoncé au verrou global de fusion, impossible à répliquer à cette échelle, et s’appuie sur les tests après fusion et avant déploiement. Les conflits entre changements concurrents existent, mais Claude les résout généralement avant qu’un humain ne les voie. Ce n’est pas de la magie : c’est un pari sur la qualité des tests, et un déplacement du risque vers l’aval.
Épilogue
Git n’est pas mort, et Scion ne le remplacera pas. Ce qui est mort, c’est l’idée qu’un outil conçu pour le rythme humain tiendra indéfiniment quand des agents écrivent à un autre rythme.
Anthropic annonce que ces problèmes deviendront courants d’ici six à douze mois, et propose d’en porter certaines idées dans git, avec GitHub, GitLab et la communauté open source. La question n’est donc pas de savoir si vous allez réécrire votre contrôle de source. Elle est de savoir si vous avez mesuré à quel moment votre infrastructure a cessé d’être dimensionnée pour ceux qui l’utilisent.
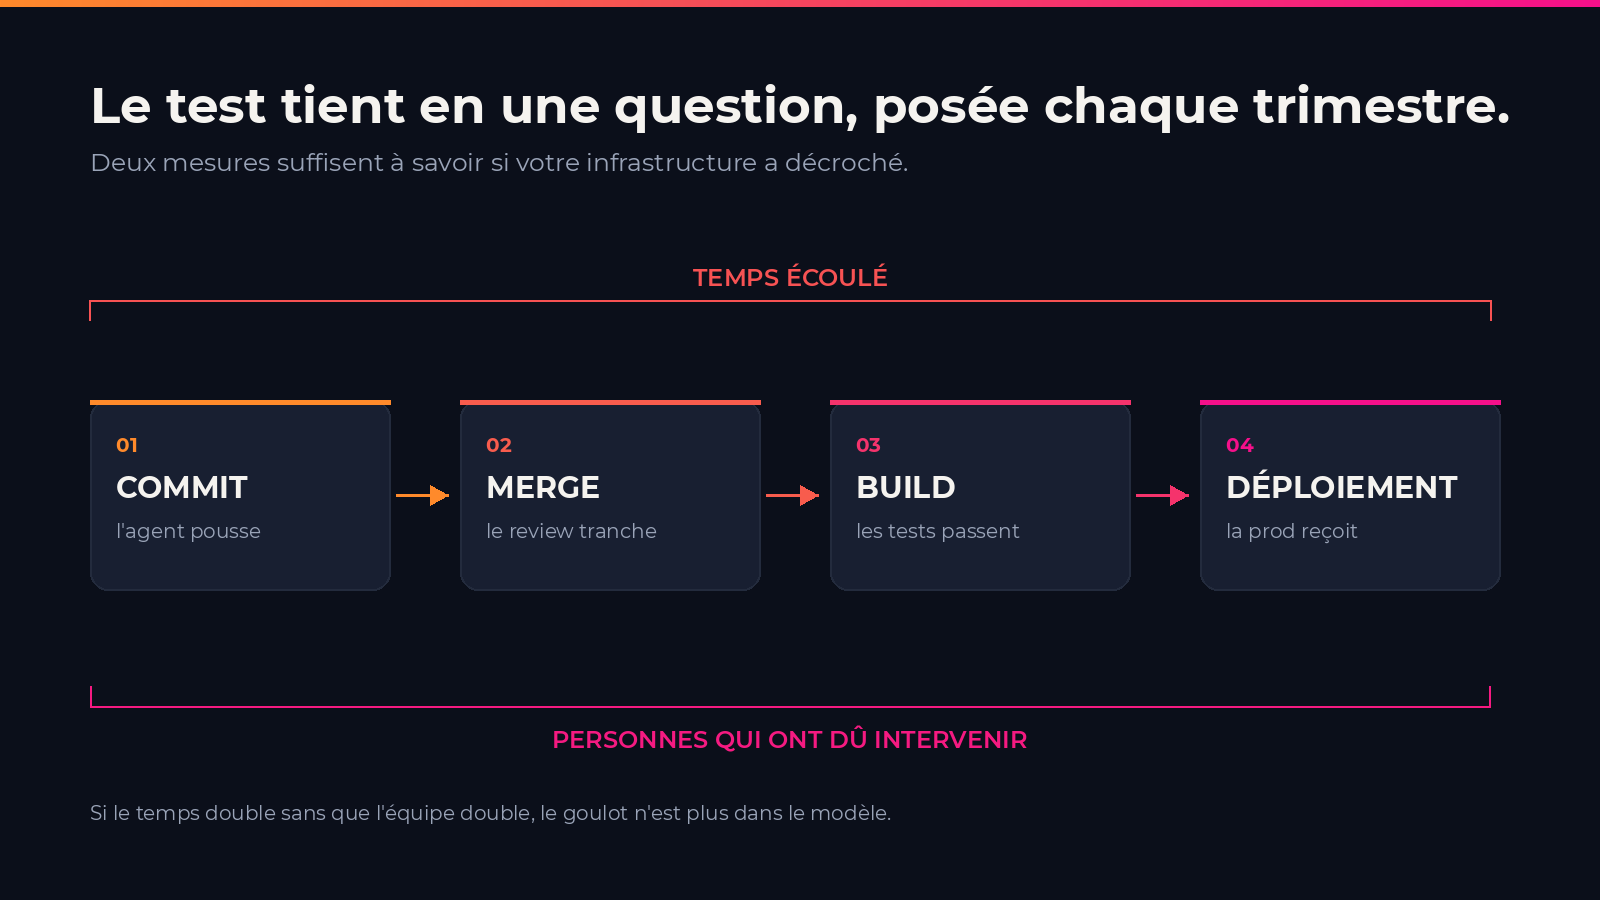
Le test tient en une question, posée chaque trimestre : quel est le temps entre le premier commit d’un changement et son déploiement, et combien de personnes ont dû intervenir pour le faire passer ? Tant que la réponse tient sous vos seuils, gardez git. Le jour où elle double sans que l’équipe ait doublé, vous saurez où chercher. Ce ne sera pas dans le modèle.
Pour aller plus loin
- Comparatif des harness IA : six plateformes passées au crible — ce qui distingue vraiment les outils, au-delà du modèle appelé.
- Le harness est devenu une commodité, la marge est ailleurs — pourquoi la valeur se déplace vers l’orchestration et les coûts.
- Beemm Vision — orchestration multi-fournisseurs, droits par équipe et traçabilité des générations, pour les équipes qui produisent des contenus à volume.
- GPT-6 Astra : ce que le modèle fait vraiment de nouveau — la lecture technique, chiffres et limites à l’appui.
Sources et références
- Anthropic Engineering, « Redesigning source control », 13 octobre 2026 — architecture de Scion, chiffres du monorepo (100 Go d’historique, 25 Go de copie de travail, 25 millions de checkouts par jour), résultats de cache et de CPU, décisions de conception.
- Pasquale Pillitteri, « Anthropic unveils Scion, the source control system that replaced git », 13 octobre 2026 — synthèse et mise en contexte de l’annonce.
- Google, article Piper et Meta, client Sapling (open source depuis 2022) — inspirations citées par Anthropic.
- Beemm, retours de mission Pathé Studio, 2026 — taux de génération effectifs, files fournisseurs, coûts Firebase et droits par équipe sur un déploiement Beemm Vision.
Article rédigé par l’équipe Beemm : Guic (Co-fondateur & CTO, consultant expert IA et agentic), Samy (CEO & Chief Creative Technologist), Jaja (Co-fondateur & Sales/Growth), Frat (Co-fondateur & Marketing). Dernière mise à jour : 1er novembre 2026.