Un contrôle de santé a mis Microsoft à terre
TL;DR Le 12 novembre au soir, Exchange Online a cessé de répondre pendant plus de vingt-quatre heures. Le trafic n’avait pas augmenté. Ce sont les sondes de santé de Microsoft qui ont retiré du pool de production des milliers de serveurs encore fonctionnels, après un changement réseau mal digéré. La charge s’est reportée sur le reste, qui a saturé à son tour. Un automatisme de disponibilité a fabriqué la panne qu’il devait empêcher. 7,4 millions de signalements plus tard, la vraie question est : combien d’entre nous ont le même engrenage ?
Jeudi 12 novembre, 17 h 25 GMT. Les premiers signalements tombent sur Downdetector, d’abord aux États-Unis, puis en Europe au moment où les journées de travail commencent. Outlook ne charge plus. Les boîtes Exchange Online sont muettes, en web, en MAPI, sur mobile, et jusque dans les appels REST que les outils internes utilisent sans le dire à personne. Puis Teams, SharePoint, OneDrive, Copilot, Defender XDR. Le lendemain à midi, la reprise commence à peine. Le samedi, Microsoft annonce que tout est revenu.
Ce qui rend cette panne intéressante n’est pas sa durée, même si Reuters la classe parmi les plus longues de l’histoire de l’entreprise. C’est son mécanisme. Elle n’a pas été causée par une attaque, Microsoft l’a répété, ni par un pic de trafic : la société a même précisé que la charge globale n’avait pas augmenté. Elle a été causée par un contrôle de santé qui a fait exactement ce pour quoi on l’avait écrit, dans un contexte où ce qu’il mesurait ne voulait plus rien dire.
Le nuage ne tombe presque jamais là où on l’attend
L’idée reçue est simple : un grand cloud tombe parce qu’il est attaqué, ou parce qu’il reçoit trop de monde. On imagine une vague, un barrage qui déborde. C’est l’image que vendent les tableaux de bord, avec leurs courbes de trafic et leurs pourcentages de disponibilité. Elle est rassurante parce qu’elle désigne un coupable extérieur.
La réalité de la plupart des pannes majeures ressemble plutôt à un videur de boîte de nuit. Il a une consigne : si le détecteur de métaux sonne, la personne n’entre pas. Un soir, le détecteur est mal réglé. Il sonne sur tout le monde. Le videur applique la consigne, la file se vide, la salle se retrouve avec douze clients et un videur irréprochable. À aucun moment il n’a désobéi. À aucun moment il n’a été méchant. Le système a fait ce qu’on lui demandait, sur une information devenue fausse, et personne n’avait prévu le cas où la mesure elle-même serait cassée.
Un health check est ce videur. Il interroge périodiquement un serveur, généralement sur un port, une URL ou une réponse applicative. Si la réponse ne vient pas dans le délai, il considère le serveur comme malade et le retire du pool qui reçoit le trafic. C’est la brique la plus utile d’une architecture distribuée : elle permet de redémarrer une machine sans couper le service, de remplacer un disque sans que l’utilisateur s’en aperçoive, de tenir dix ans de croissance sans intervention humaine. C’est aussi la brique la plus dangereuse, parce qu’elle a le droit de supprimer des ressources en production, automatiquement, en quelques secondes, sans qu’aucun humain ne soit dans la boucle.
Ce 12 novembre, le détecteur de métaux était déréglé. Une modification récente de l’infrastructure réseau a rendu les serveurs injoignables depuis le point de vue des sondes, alors qu’ils continuaient à traiter des requêtes. Les sondes ont conclu à la maladie. Le pool s’est vidé par le haut.
Six pièces, un seul engrenage
La chronologie publiée par Raphaël Angleraux, CTO et cofondateur d’Icodia, à partir des mises à jour de Microsoft, permet de suivre pièce par pièce. Elle se lit comme une série de décisions locales parfaitement raisonnables, dont l’empilement produit une catastrophe globale.
1. Un changement réseau anodin. Une modification de configuration est passée, du type de celles qu’un opérateur réseau pousse plusieurs fois par semaine. Microsoft n’a pas publié son contenu. On sait seulement qu’elle coïncide avec le début de l’incident, et que son rollback a été engagé dans la nuit.
2. La sonde regarde au mauvais endroit. Le contrôle de santé emprunte un chemin que le changement réseau a cassé. Le serveur est vivant, mais la sonde ne le voit plus. C’est le faux positif au sens strict : l’outil de mesure produit une information fausse sur un système qui va bien.
3. Le retrait automatique. Le gestionnaire de pool applique sa règle : pas de réponse, pas de trafic. Les serveurs sortent de la rotation un par un. À ce stade, le service perd de la capacité alors qu’aucune machine n’est réellement en panne.
4. Le report de charge. Le trafic restant se concentre sur les serveurs encore dans le pool. Le volume global est stable, mais la répartition ne l’est plus. Chaque serveur survivant reçoit la charge de ceux qui viennent d’être écartés, plus la sienne.
5. Le goulot qu’on n’avait pas modélisé. Un processus chargé d’établir les connexions sécurisées sature. Les serveurs redevenus disponibles cessent de répondre dès qu’ils reçoivent du trafic. C’est le point où la panne change de nature : on ne cherche plus à réparer un composant, on cherche pourquoi un serveur sain s’effondre à la première requête.
6. Le retour en service qui casse à nouveau. Microsoft redémarre, réintègre, limite certains types de requêtes, reconstruit des serveurs avec une version logicielle antérieure. Chaque réintégration massive reproduit localement le pic qu’on voulait éviter. La reprise devient un exercice de dosage : assez de serveurs pour absorber la charge, pas assez pour que le processus de connexions sature de nouveau.
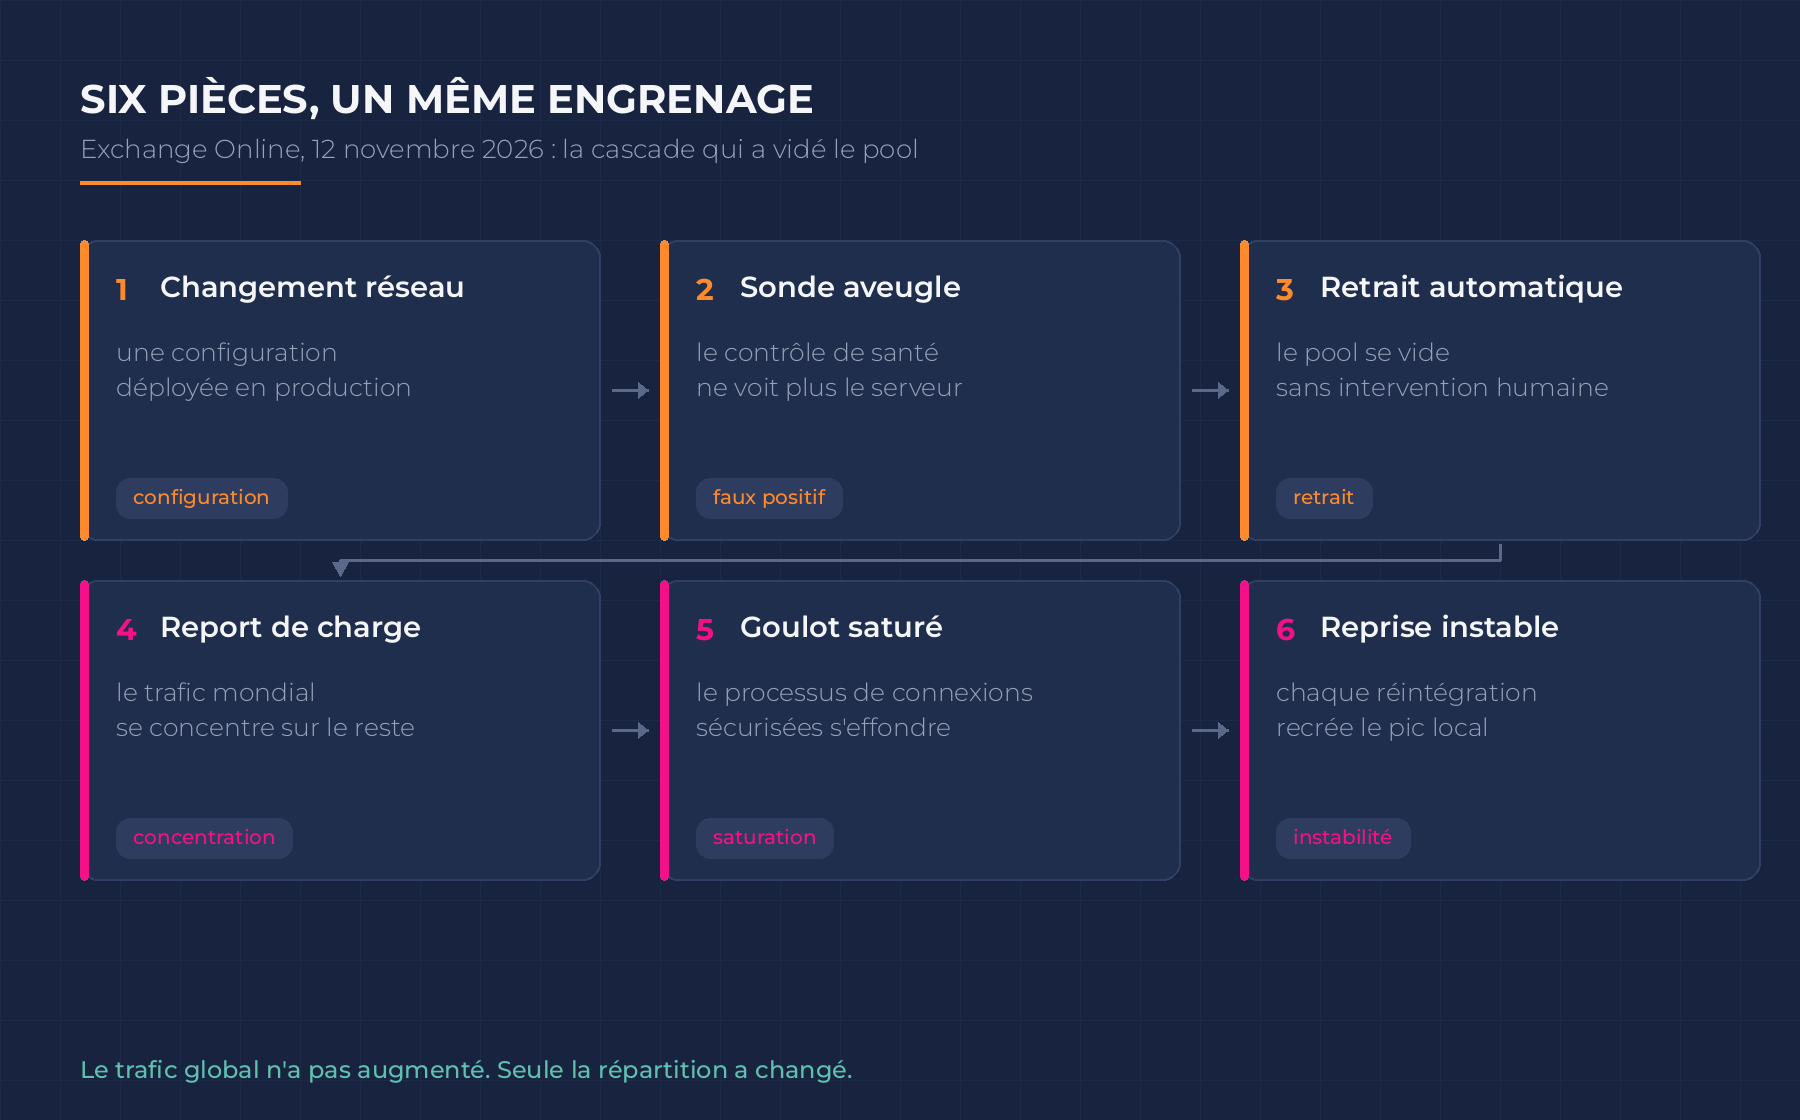
La cascade du 12 novembre. Le trafic global est resté stable : seule sa répartition a changé.
Microsoft a fini par contourner le composant qui traitait les contrôles de santé, avec une méthode alternative testée sur une partie des serveurs avant généralisation. C’est la bonne décision, et elle dit quelque chose de dérangeant : la sortie de panne consistait à désactiver le mécanisme censé garantir la disponibilité. Pendant plusieurs heures, la meilleure façon de tenir le service a été de ne plus croire ses propres sondes.
Ce que la journée a coûté
Les chiffres disponibles donnent la mesure du basculement. Downdetector, via sa maison mère Ookla, a enregistré plus de 7,4 millions de signalements dans le monde, avec un pic proche de 20 000 par minute, soit environ 1 500 fois le niveau normal. Le Guardian rapporte 130 000 signalements dans 74 pays dès la première soirée, et plus de 430 millions d’utilisateurs de Microsoft 365. La société indique que 90 % des entreprises du Fortune 500 utilisent Copilot.
La liste des organisations touchées dit mieux que les pourcentages ce que signifie « dépendance ». Le NHS britannique est revenu au papier et aux systèmes parallèles dans plusieurs services locaux. La police métropolitaine de Londres a prévenu que certains signalements en ligne n’étaient plus possibles, tout en assurant que les appels d’urgence fonctionnaient. La Chambre des représentants américaine a diffusé une alerte interne. L’agence de renseignement australienne et la police fédérale ont perdu la messagerie. Euronext a signalé des perturbations de courriel, Aviva a activé ses solutions de repli pour sa publication de résultats, Maersk a prévenu ses clients de retards, IndiGo, Akasa Air et Air India ont reconnu des support clients dégradés.
Le détail le plus parlant vient de Taïwan. Selon Reuters, une société de gestion d’actifs a annulé une opération de rachat d’obligations, et une autre a confirmé des transactions par fax. Le fax. Pas parce que le fax est une bonne technologie, mais parce que c’était le seul canal encore debout dans le bâtiment.
Côté assurance, Mario De Cicco, vice-président de Morningstar DBRS, estime les pertes assurées mondiales entre 300 et 500 millions de dollars. À comparer aux 400 millions à 1,5 milliard de dollars estimés pour CrowdStrike en 2024, qui avait immobilisé plus de 8 millions de machines Windows. Le montant est plus faible, la leçon est la même : dans les deux cas, ce n’est pas une attaque qui a mis le système à genoux, c’est une poussée de configuration, un automatisme appliqué à l’échelle mondiale sans palier de sécurité.
Un détail technique mérite d’être souligné, parce qu’il circule mal. Microsoft a publié ses mises à jour du Patch Tuesday deux jours avant, dont 1 094 correctifs et une vulnérabilité Outlook activement exploitée, CVE-2026-124194. Aucun lien n’a été établi entre cette faille et la panne, et la société a écarté l’hypothèse d’une activité malveillante. Il faut le dire clairement : chercher un attaquant ici, c’est refuser de regarder le vrai problème. Le vrai problème est interne, et il est structurel.
Ce que nos propres tuyaux racontent
Il serait confortable de traiter cette panne comme un accident industriel réservé à Redmond. Nous avons vécu sa version miniature le jour même, sur un déploiement Beemm.
Une page du site avait été corrigée. Le déploiement a fait ce que font tous les déploiements : remplacer les instances une par une, sans couper le service. Pendant plusieurs minutes, deux versions de la même page ont donc coexisté derrière la même adresse. Le contrôle automatique, lui, interrogeait l’URL une fois, recevait une réponse correcte, et concluait que tout allait bien. C’est un testeur qui passe une seule porte et déclare l’immeuble vide.
La vérification manuelle, avec un paramètre qui contourne le cache et une dizaine d’appels successifs, a montré qu’environ une requête sur dix servait encore l’ancienne version, liens cassés compris. Rien de grave : un article, pas un système de messagerie. Mais le mécanisme est identique à celui de Microsoft, à l’échelle d’un serveur au lieu d’un continent. Une sonde qui ne teste qu’un seul chemin, une fois, à un instant donné, ne mesure pas la disponibilité. Elle mesure la disponibilité de ce chemin, à cet instant, pour cette requête.
La différence entre les deux situations n’est pas la compétence des équipes. Elle est dans le nombre de fois où le système a le droit de se tromper avant qu’un humain regarde. Chez Microsoft, ce nombre était devenu très grand, et le coût de l’erreur s’est propagé à des centaines de millions de personnes en moins d’une heure.
Cinq garde-fous à poser avant lundi
Aucun de ces points ne demande un budget à six chiffres. Ils demandent une après-midi et un peu d’honnêteté sur ce que vos outils mesurent vraiment.
1. Tester le parcours utilisateur, pas le port. Un health check qui vérifie qu’un processus écoute est un test de présence, pas de disponibilité. Il doit effectuer l’action réelle : se connecter, envoyer un message, lire une réponse, avec les mêmes chemins réseau que le client. Sinon il validera un serveur que personne ne peut joindre.
2. Plafonner l’automatisme. Un système qui peut retirer 100 % du pool n’a pas de garde-fou, il a une politique de suicide. Fixez un plafond : jamais plus de 20 ou 30 % de la capacité retirée automatiquement, au-delà, alerte humaine et gel des décisions. C’est un disjoncteur, pas une optimisation.
3. Faire passer les changements réseau par un canari réel. Une modification de configuration doit toucher une région, un pool, un pourcentage, et être observée sur les métriques du service avant généralisation. Selon la chronologie de l’incident, Microsoft a suspendu tous ses déploiements une heure environ après les premiers symptômes : c’est la bonne réaction, appliquée trop tard.
4. Prévoir un canal qui ne dépend pas du fournisseur. Le plan de continuité qui tient dans un slide ne vaut rien le jour où la messagerie tombe. Il faut un numéro de téléphone, une liste de contacts hors système, un document accessible sans authentification unique, et des personnes qui savent quoi faire sans consulter leur boîte. Le fax taïwanais n’est pas une anecdote, c’est un canal de secours qui a fonctionné.
5. Journaliser les actions automatiques, et pouvoir les arrêter. Chaque agent, script ou opérateur qui modifie la production doit écrire ce qu’il a fait, pourquoi, et sur quel signal. Un humain réveillé à 3 h doit pouvoir lire ce journal en dix minutes et couper l’automatisme d’un seul bouton. Sans cela, vous n’exploitez pas un système, vous assistez à un système.
Ce que ça change pour l’IA
La question n’est plus théorique depuis que des agents ont des droits d’écriture. Un agent qui classe mal un ticket coûte quelques minutes. Un agent qui redémarre un service parce qu’une métrique a franchi un seuil, sans comprendre que la métrique est fausse, produit exactement la panne du 12 novembre, en plus rapide et sans que personne n’ait écrit la règle à la main.
C’est pourquoi la valeur d’un déploiement d’IA ne se mesure pas au nombre d’actions qu’il automatise, mais au nombre d’actions qu’il refuse de faire seul. Les équipes qui réussissent leurs agents en production sont celles qui leur donnent un journal lisible, un droit de veto humain sur les opérations destructrices, et une sortie de secours qui ne passe pas par le fournisseur du modèle. Les autres découvrent le problème un jeudi soir, quand les sondes se mettent à mentir.
Épilogue
Le videur n’était pas méchant. Il appliquait la consigne, avec un détecteur déréglé, dans une boîte où personne n’avait écrit la procédure du soir où le détecteur se trompe.
Microsoft a promis un rapport post-incident complet, avec cause racine et actions de défense en profondeur. Il faudra le lire, pas pour savoir si Redmond est compétent, mais pour vérifier une chose précise : à quel moment de la chaîne un humain avait le droit de dire « non, ce serveur va bien ». Si la réponse est « nulle part », alors la panne n’est pas un accident. C’est un choix d’architecture, et il est reproduit dans des milliers de systèmes plus petits, dont le vôtre.
Rédaction Frat Frat (Beemm). Sources : Reuters, The Guardian, SecurityWeek, et la chronologie publiée par Raphaël Angleraux (Icodia). Chiffres de pertes assurées : estimation Morningstar DBRS. Aucune activité malveillante retenue par Microsoft à ce stade ; rapport post-incident attendu.