Harness Leaderboard : 24 points d’écart à modèle identique
TL;DR Neuf harness, trois modèles open source, 29 000 essais. À modèle, fournisseur et effort identiques, le taux de réussite va de 27,3 % à 51,4 %, et le coût par tâche résolue de 0,29 $ à 3,35 $. Le classement départage enfin ce que les annonces vendaient comme un progrès de modèle. Il montre aussi que les cinq premiers tiennent dans la marge d’erreur, et que la décision d’achat se joue sur le coût par tâche résolue et la régularité sur trois essais, pas sur un point de pourcentage.
Depuis un an, la question posée en comité de direction est toujours la même : « quel modèle on prend ? ». Le Harness Leaderboard, publié sur Hugging Face par Joël Niklaus, répond à une question plus utile. À modèle constant, combien rapporte l’enveloppe logicielle qui relie ce modèle à un terminal, à des outils et à un dépôt de code ?
La réponse tient en trois chiffres. 24 points séparent le meilleur harness du plus mauvais. Le coût par tâche résolue varie d’un facteur 11,6. Et sur le modèle le plus capable du panel, le même modèle passe de 36,1 % à 71,3 % de réussite selon l’enveloppe qui l’entoure. Autrement dit, le harness n’est pas un détail d’implémentation. C’est une ligne de coût et une ligne de résultat.
Ce que le classement mesure vraiment
La méthode est ce qui donne sa valeur au classement. Neuf harness tournent sur trois modèles open source : Flint, DeepSeek-V4.1-Flash et GLM-5.3-Flash. Chaque couple modèle, harness et effort de raisonnement passe trois fois sur chaque tâche, dans une sandbox Hugging Face, pilotée par Harbor. Les versions des harness sont épinglées, le fournisseur d’inférence est le même pour tous, et un proxy de comptage mesure les tokens, les appels et le temps modèle en dehors du harness.
Deux benchmarks servent de juge. Terminal-Bench 2.1, avec 87 tâches notées sur 89, couvre la configuration, le débogage et la recherche en terminal. DeepSWE v1.1, avec 111 tâches notées sur 113, couvre des fonctionnalités longues dans de vrais dépôts Go, Python, TypeScript et Rust. Toutes les trajectoires sont publiées dans un bucket public. Un harness qui triche est compté comme un échec, et les tâches où le modèle n’a jamais eu la réponse sont exclues du score.
Le total donne 29 000 essais et 4 746 $ de facture. C’est le prix d’un benchmark sérieux en 2026, et c’est aussi la première chose à retenir : personne ne peut plus dire qu’il ne savait pas mesurer.
Les chiffres, sans tableau
Le classement complet, du premier au dernier, avec le taux de réussite macro et le coût par essai puis par tâche résolue.
- mini-swe-agent v2.4.6 : 51,4 %, 0,17 $ par essai, 0,53 $ par tâche résolue.
- Kimi Code v2.2.0 : 50,5 %, 0,19 $, 0,62 $.
- Hermes Agent v0.22.1 : 50,3 %, 0,17 $, 0,65 $.
- Pi v1.2.0 : 49,4 %, 0,094 $, 0,29 $.
- Claude Code v2.1.300 : 49,2 %, 0,14 $, 0,52 $.
- Qwen Code v0.25.2 : 44,7 %, 0,12 $, 0,34 $.
- Codex v0.162.1 : 44,5 %, 0,17 $, 0,71 $.
- OpenCode v1.19.0 : 35,5 %, 0,36 $, 3,35 $.
- OpenClaw v2026.10.4 : 27,3 %, 0,20 $, 1,43 $.
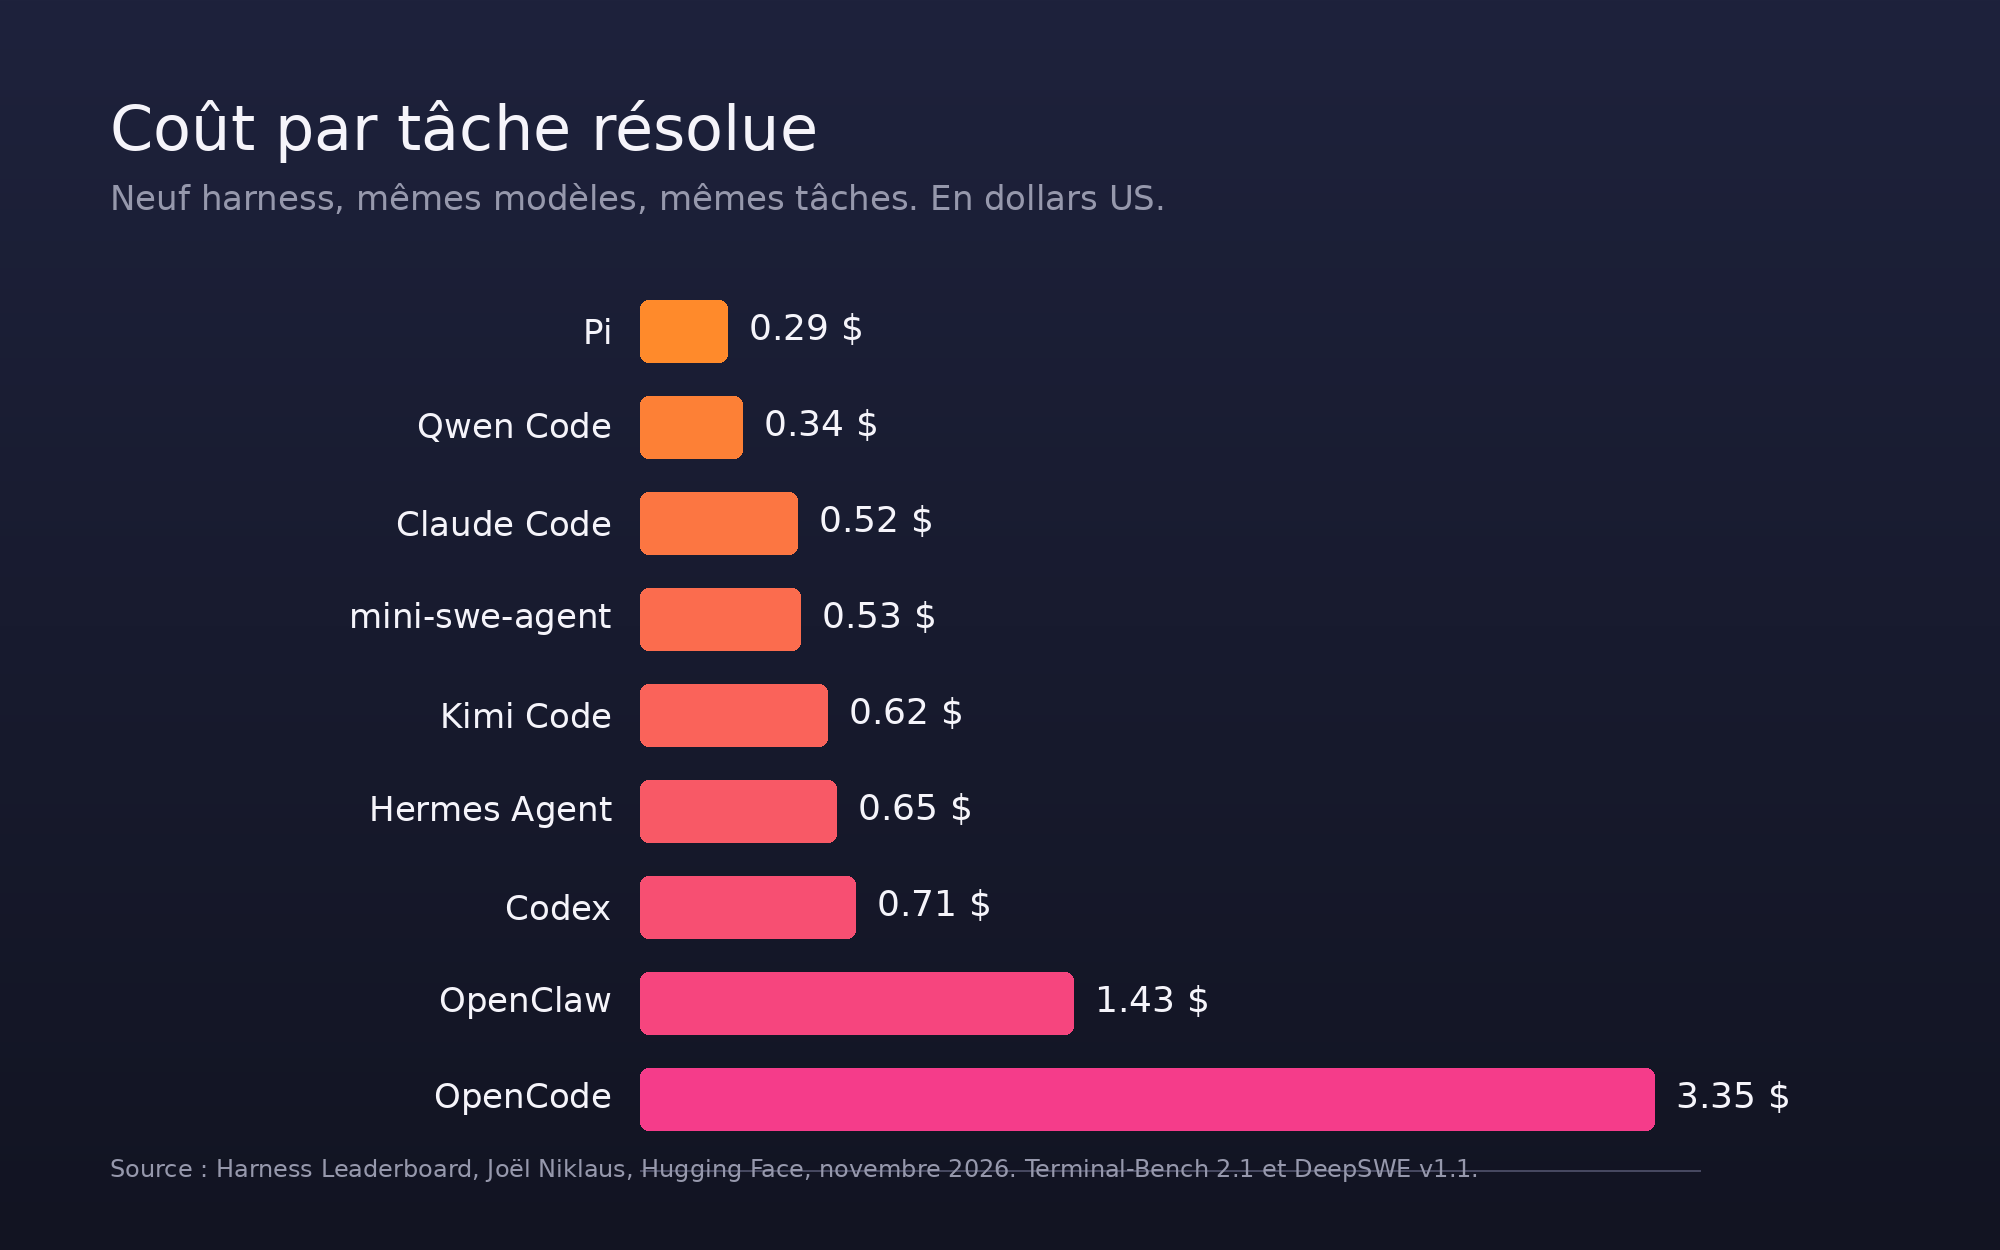
Trois lectures sautent aux yeux.
Un peloton de tête à 2,2 points
Cinq harness se tiennent entre 49,2 % et 51,4 %, soit 2,2 points d’écart pour des intervalles de confiance de presque 3 points de chaque côté. Le classement le dit lui-même : Kimi Code, Hermes Agent, Pi et Claude Code sont déclarés à égalité avec le leader, parce que l’intervalle de confiance bootstrap de la différence couvre zéro. Un responsable qui choisit le premier parce qu’il a 1,1 point de plus choisit du bruit.
Le coût ne suit pas le score
Pi est quatrième avec 49,4 % et coûte 0,29 $ par tâche résolue, presque deux fois moins que le leader. OpenCode est huitième avec 35,5 % et coûte 3,35 $ par tâche résolue, soit 11,6 fois plus. Le même travail, facturé d’un ordre de grandeur près, selon l’enveloppe.
62 minutes contre 24
OpenCode passe 62,6 minutes par essai, contre 23,7 minutes pour Qwen Code. Sur des workflows qui tournent la nuit, cette différence décide du nombre de tâches qu’on peut lancer avant le matin.
Le même modèle, 35 points d’écart
Le chiffre le plus parlant n’est pas dans le classement général, il est dans la colonne d’un seul modèle. Sur DeepSeek-V4.1-Flash, Hermes Agent atteint 71,3 % et OpenClaw 36,1 %. Même modèle, même fournisseur, même effort : 35 points de réussite en plus ou en moins, uniquement à cause du harness.
Sur GLM-5.3-Flash, l’écart reste de 21,8 points entre le meilleur (62,1 %) et le plus faible (40,3 %). Sur Flint, le modèle le plus difficile du panel, tous les scores s’écrasent entre 5,6 % et 21,6 %, mais l’ordre relatif change encore.
Cette colonne casse un récit confortable. Celui qui dit qu’on choisit un modèle puis qu’on l’exécute. En pratique, on choisit un couple. Le modèle fixe le plafond théorique, le harness fixe la part de ce plafond qu’on atteint réellement, et la facture pour y arriver.
Harness contre bruit : 5,7 points, pas 24
La partie la plus honnête du site est celle qui mesure le bruit. Une tâche bascule quand un essai passe et que l’autre échoue. Si changer de harness ne fait pas basculer plus de tâches que relancer le même harness, alors le choix du harness ne change pas grand-chose au-delà du hasard.
Les chiffres sont sans appel. Relancer le même harness fait basculer 23,4 % des tâches. Changer de harness en fait basculer 29,1 %. Changer de modèle, 33,6 %. Changer d’effort de raisonnement, 27,3 %. Le harness ajoute donc 5,7 points de bascule au-dessus du bruit de relance. C’est réel, c’est mesurable, et c’est loin des 24 points de l’écart brut.
L’article de Yangze Liu et Zhongyi Han, publié le 3 octobre 2026 sur arXiv, va dans le même sens avec une autre méthode. Sur SWE-bench Verified, avec cinq modèles et trois harness de production, changer de harness fait basculer 13 % des tâches, exactement comme relancer le même harness. Claude Code et mini-SWE-agent, le plus lourd et le plus léger, sont équivalents à cinq points près. Le seul effet qui dépasse le bruit est une perte : OpenCode jusqu’à 9 points de retard, dont la moitié vient de plafonds de sortie qui coupent les runs.
La conclusion est désagréable pour les deux camps. Les vendeurs de harness ne peuvent pas revendiquer 20 points de gain. Les acheteurs ne peuvent pas traiter le harness comme un détail interchangeable. L’effet est modeste sur le score, massif sur la facture.
Ce qui fait le prix : cinq pièces
Le même article explique d’où vient l’écart de coût, et c’est la partie la plus actionnable pour une équipe technique.
Le prix se fixe dès le premier appel, par le préambule du prompt système et par les schémas d’outils que le harness envoie à chaque étape. Un harness bavard paie ce bavardage à chaque tour, puis multiplie par le nombre d’étapes. Les cinq pièces qui décident de la note sont donc :
- Le préambule du prompt système, souvent copié d’un modèle à l’autre sans mesure.
- Les schémas d’outils, dont la taille varie d’un facteur important entre un harness minimal et un IDE agentique complet.
- La gestion du contexte, qui décide de ce qu’on renvoie au modèle et de ce qu’on compacte.
- La boucle de vérification, qui arrête ou relance, et donc le nombre d’étapes facturées.
- Le plafond de sortie, qui coupe parfois le travail au milieu et transforme un essai en échec payé plein tarif.
Le dernier point est le plus vicieux. Un plafond mal réglé ne dégrade pas seulement le score, il fait payer une tentative qui n’aboutira jamais. Sur OpenCode, la moitié de l’écart avec le leader vient de là. Ce n’est pas un problème de modèle, ni de prix du token. C’est un paramètre d’enveloppe que personne ne regarde.
Trois tentatives, pas une
Le classement publie aussi la régularité, et c’est la métrique que les équipes oublient. Chaque barre va de la part de tâches résolues aux trois essais à la part résolue au moins une fois. L’écart entre les deux extrêmes mesure la chance, pas la compétence.
Pour un agent qu’on laisse tourner la nuit, la bonne question n’est pas « combien de tâches sait-il faire » mais « combien de tâches refait-il à chaque fois ». Un harness qui réussit une tâche sur trois une fois sur trois coûte trois fois plus cher et casse la confiance de l’équipe qui relit derrière. La régularité est un critère d’achat, au même titre que le score.
Cette lecture change aussi la façon de tester en interne. Une campagne à un seul essai par tâche mesure surtout la variance. Trois essais coûtent trois fois plus cher et donnent une information utilisable.
Ce que ça change dans une décision d’achat
Quatre conséquences pratiques, dans l’ordre où elles se posent.
D’abord, arrêter de comparer les modèles sans fixer le harness. Un tableau qui mélange les enveloppes compare des couples, pas des modèles, et la conclusion ne tient pas au changement de fournisseur.
Ensuite, mettre le coût par tâche résolue dans le dossier d’achat, à côté du prix du million de tokens. C’est la seule unité qui intègre le taux de réussite, le nombre d’étapes et le bavardage du prompt. Un modèle deux fois moins cher avec un harness bavard peut coûter plus cher au résultat.
Puis, exiger les trajectoires. Un score sans trace ne se vérifie pas. Les trajectoires publiques du classement montrent où l’agent perd du temps, où il boucle, où il dépasse son plafond de sortie. C’est là qu’on trouve les gains, pas dans le classement.
Enfin, accepter que le top 5 soit un match nul. À 2 points près et avec des intervalles qui se chevauchent, le choix se fait sur l’ergonomie, la licence, la langue de travail et le coût, pas sur le score.
Les limites du classement
Le classement est propre, il n’est pas universel. Trois modèles open source seulement, tous choisis pour être servis par des fournisseurs d’inférence, plus Flint sur un endpoint dédié. Neuf harness, dont certains en version approximative. Deux benchmarks de code, partiels par construction, avec 87 tâches sur 89 et 111 sur 113. DeepSWE mélange des tâches en ligne et hors ligne, ce qui interdit de comparer finement deux harness sur ce seul score.
Et surtout, tout cela mesure du travail de développement en terminal. Rien ici ne dit comment un harness se comporte sur de la production visuelle, de la rédaction ou de l’analyse de données, qui sont les usages réels de la majorité des équipes marketing et produit. La méthode, elle, se transpose. Les chiffres, non.
Ce qu’on en fait chez Beemm
On fait tourner nos propres agents sur Hermes Agent, troisième du classement avec 50,3 % et 0,65 $ par tâche résolue. Ce n’est pas un argument de vente, c’est une coincidence utile : on utilise l’un des harness mesurés, et on peut donc confronter notre expérience au protocole.
Ce que le classement nous a fait changer, avec Guic, tient en trois règles. On ne valide plus un agent sur un seul essai. On rapporte le coût au livrable accepté, pas au token consommé. Et on lit les trajectoires avant de lire les scores, parce que la cause d’un échec est presque toujours dans l’enchaînement des étapes, rarement dans le modèle.
La même grille vaut pour un agent de production créative. Trois passes, un coût par livrable accepté, un audit des trajectoires. La différence, c’est que le juge n’est pas un test unitaire mais un relecteur. Le principe, lui, ne bouge pas.
Les outils Beemm pour passer à l’action
Si vous devez arbitrer entre deux harness, deux modèles ou deux façons de déployer des agents, l’atelier agents IA de Beemm part de vos tâches réelles et construit le protocole de mesure avec vos équipes. Trois passes par tâche, coût par livrable accepté, grille de relecture. Réserver un atelier agents IA.
Pour aller plus loin
Articles qui complètent celui-ci :
- Comparatif 2026 : 6 harness d’agents IA, lequel choisir pour votre cas pour la cartographie des enveloppes et la matrice de décision en trois questions.
- Anthropic Scion : le contrôle de source des agents pour comprendre ce qui se passe quand un agent écrit directement dans votre dépôt.
- Le modèle est une commodité, le harness est la marge pour la version stratégique de cet argument, avec trois cas d’usage.
Sources et références
- Harness Leaderboard, Joël Niklaus (Hugging Face) : classement, méthode, intervalles de confiance et trajectoires publiques, consulté le 8 novembre 2026.
- What Does a Harness Buy? Tokens, Mostly, Yangze Liu et Zhongyi Han, arXiv 2610.04433 : cinq modèles, trois harness, SWE-bench Verified, 3 octobre 2026.
- Terminal-Bench 2.1 : benchmark terminal, commit d49e28f.
- DeepSWE v1.1 : benchmark long horizon, commit 0b9fabb.
- Harbor : orchestrateur d’essais utilisé par le classement.
Rédaction Frat Frat (Beemm), relecture technique Guic (Beemm).